flowchart LR
    subgraph NonTP["非张量并行区显存对比 (LN / Dropout / 残差)"]
        direction TB
        Standard["标准 TP: 显存不切分<br>每卡持有全部 s 个 token<br>显存开销 = 100%"]
        SP["序列并行 SP: 沿序列切分<br>每卡仅持有 s / TP 个 token<br>显存开销 = 1 / TP"]
    end
第 7 课:序列并行 SP
参考答案版:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
Important统一完成标准与及格线
代码 4 分、Q1~Q3 各 2 分,通过线 8/10。必须解释正确性边界、显存/通信公式中的单位与分片维度;未实际运行的内容只能标记为静态审查。
- 对应官方章节:Sequence parallelism
- 前置:第 6 课(TP)
- 状态:未开始
本课目标
完成后你需要能够:
- 说明 SP 解决的问题:LayerNorm/dropout 需要完整隐藏维度,抵消 TP 的激活节省。
- 画出一个 transformer block 在 TP 与 TP+SP 下激活形状
(b, s, h)的转换图。 - 解释 f/f* 与 g/g* 两组共轭操作在 forward/backward 中的角色。
- 说明 TP+SP 的通信量与纯 TP 相同的原因。
核心概念
1. 术语澄清:Megatron-SP 与 Context Parallelism (CP) 的本质区别
在大模型分布式系统领域,“序列并行(Sequence Parallelism)”这个词在历史上有两种完全不同的含义,面试与系统设计中极易混淆:
Megatron-SP(Korthikanti et al., 2022,本课核心):专指与机内张量并行(TP)深度绑定的优化技术。它并不改变注意力机制的计算拓扑,而是专门针对 Transformer 中未被 TP 覆盖的区域(如 LayerNorm、RMSNorm、Dropout、残差连接等),通过沿序列维度(Sequence Dimension)切分来彻底消除其显存冗余。
Context Parallelism(CP / 环形注意力 Ring-Attention,第 8 课):专指跨物理节点将全模型的长文本序列(如 32k、128k、1M 上下文)整体切分并分布式流转计算的独立并行维度。
在讨论序列并行时,必须首先明确其上下文语境。
2. 传统 TP 的显存软肋:非 TP 区域的激活冗余
回顾第 6 课,张量并行(TP)成功将 MLP 和 Attention 核心的 GEMM 权重切分到各个 GPU 上,其内部中间激活张量的隐藏维度也被切分为 。
然而,如图 7-1 与图 7-2 的对比所示,在 GEMM 算子之外的非 TP 区域,系统面临严峻的显存回弹:
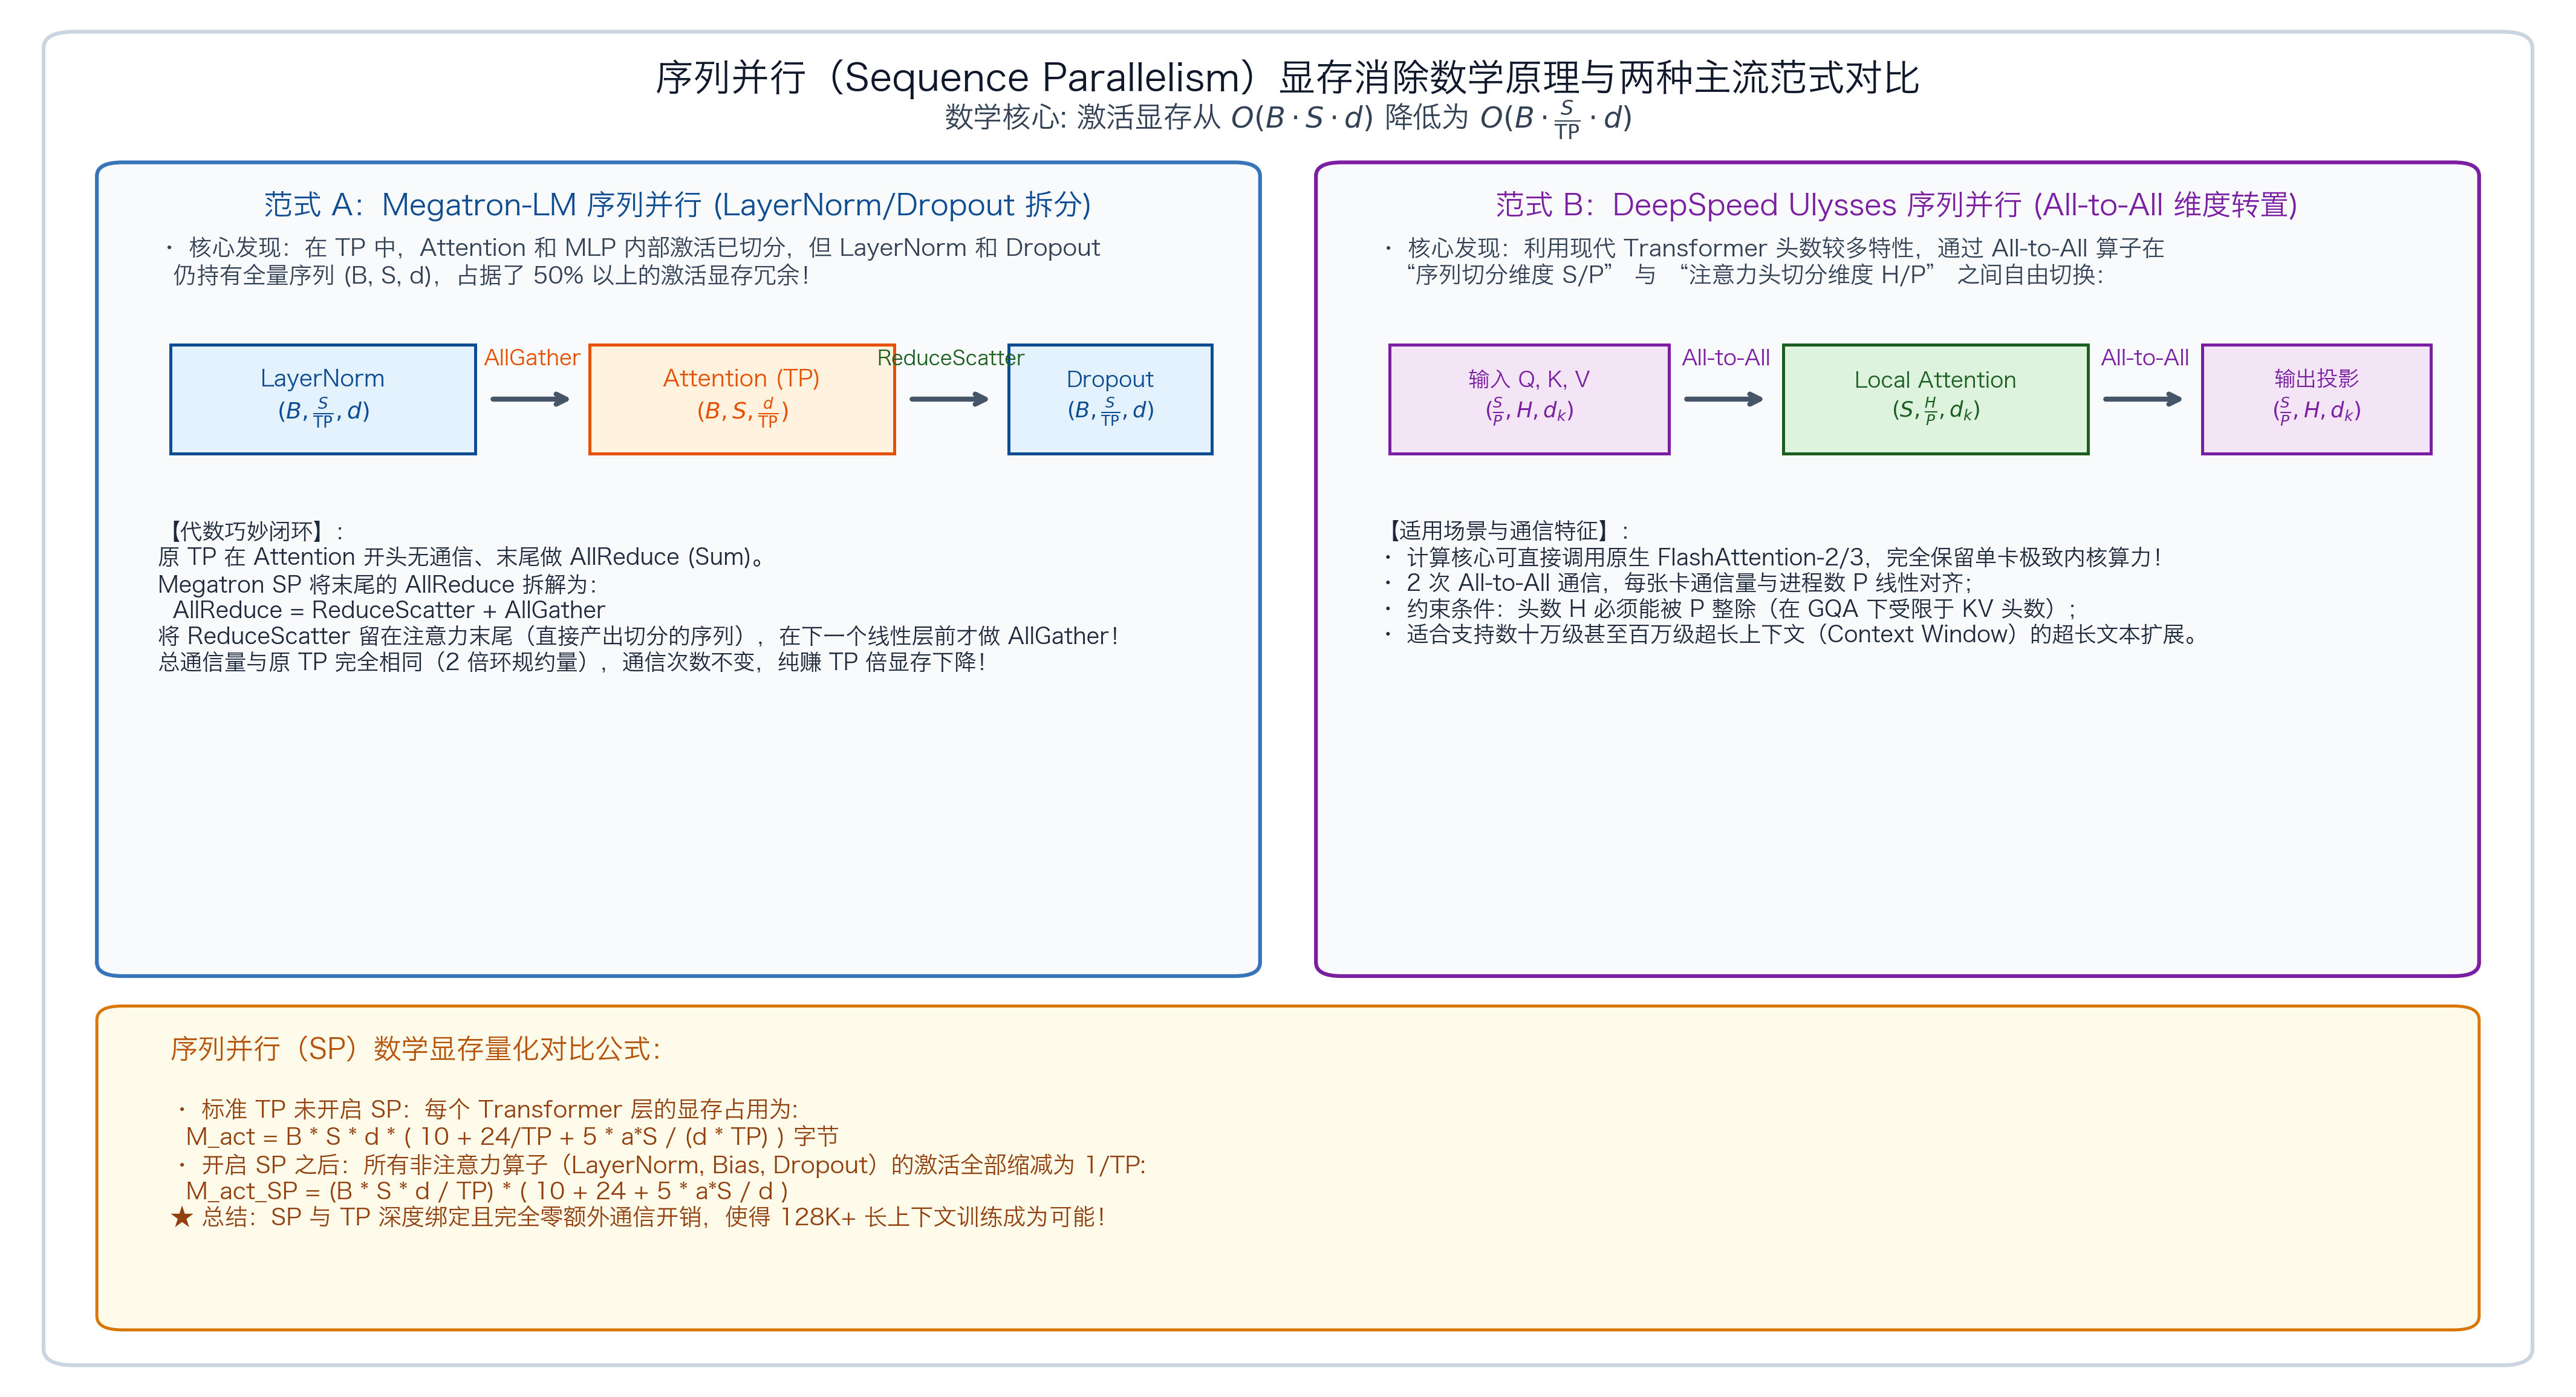
图 7-1:序列并行(SP)显存消除数学原理与 Megatron-SP vs DeepSpeed Ulysses 两种主流范式对比
图 7-2:序列并行(SP)切分非张量并行区激活值显存分布对比
LayerNorm / RMSNorm 的归一化计算: 均值 与方差 是沿着整个隐藏特征维度 进行统计约简的。若沿 维度切分输入,各卡仅持有一部分通道特征,根本无法独立计算出正确的均值和方差,除非在 LayerNorm 内部强行插入跨卡通信。
全量激活冗余驻留:为了避免在每个 Norm 算子内发生低效的跨卡通信,原生 Megatron-LM 规定:在进入 LayerNorm、Dropout 以及残差连接之前,必须持有全量的特征张量 。
后果:这意味着每个 TP 副本的 GPU 显存内都完整保存了一份完全相同的 激活张量。随着模型层数 与上下文长度 的增长,这些未被切分的“公共激活值”占据了反向保留激活(Stored Activations)总量的 30%~50%,严重抵消了 TP 带来的显存收益。
3. 序列切分与通信共轭对( 与 原语闭环)
Megatron-SP 捕捉到了一个核心数学事实:LayerNorm、RMSNorm、GELU 和 Dropout 均是逐 Token(Token-wise)独立执行的算子! 它们在序列维度 上没有任何交叉依赖——第 1 个 Token 的归一化结果与第 100 个 Token 的归一化完全互不影响。
因此,完全可以沿序列维度 将非 TP 区域的张量均分为 块,让每张卡仅驻留 的局部序列激活!
为了在 SP 区域(序列切分)与 TP 区域(隐藏维切分)之间无缝转换,Megatron 引入了优雅的共轭算子对(Conjugate Operator Pairs),其执行拓扑如图 7-1 与图 7-3 所示:
sequenceDiagram
    autonumber
    participant SP_Region as 序列并行区 [s/tp, b, h]
    participant AG as AllGather (正向) / ReduceScatter (反向)
    participant TP_Region as 张量并行区 [s, b, h]
    participant RS as ReduceScatter (正向) / AllGather (反向)

    SP_Region->>AG: 动态拼合完整序列进入 Column Linear
    AG->>TP_Region: 完整序列执行局部矩阵乘与多头注意力
    TP_Region->>RS: Row Linear 局部输出直接规约切分序列
    RS-->>SP_Region: 规约后仅保留属于本卡的序列切片
图 7-3:Megatron-SP 巧妙利用 Ring 通信原语消除冗余通信的完整闭环
A. 与 算子对(SP 与 TP 区域的转换核心)
- 前向转入 TP 区域( 算子):
- 在进入 Attention / MLP 的列并行矩阵乘之前,算子需要完整的 Token 语义(例如 Attention QKV 投影需与整体位置编码配合)。
- 系统发起一次 All-Gather(沿序列维度 ):
- 随后直接送入列并行线性层,输出沿隐藏维切分的张量 。
- 前向转出 TP 区域( 算子):
- 行并行线性层计算后,各卡产生了部分和张量 。
- 在原生 TP 中,此处必须执行一次 AllReduce 沿 恢复完整和。
- 而在 SP 中,此处直接替换为 Reduce-Scatter(沿序列维度 ):
- 一石二鸟:
Reduce-Scatter既完成了行并行部分和的累加求和,又顺手将输出张量切分回了 ,直接喂给后续的 LayerNorm 与 Dropout!
B. 共轭算子的反向行为与对偶性
在自动微分(Autograd)中,反向求导是前向有向无环图的伴随转置:
- 前向执行 (All-Gather 沿 ),反向求导对应的梯度汇聚算子正是其转置对偶:Reduce-Scatter 沿 。
- 前向执行 (Reduce-Scatter 沿 ),反向求导对应的梯度恢复算子正是其转置对偶:All-Gather 沿 。
- 这种代数上的高度自洽保证了前向与反向在数学上严格等价,完全无须破坏自动求导链条。
4. 通信量守恒定理:为什么 SP 几乎是“免费的午餐”?
直觉上,引入更多的通信算子会导致通信耗时增加。但严格的集合通信带宽分析证明:Megatron-SP 没有增加任何网络传输字节量!
回顾第 3 课的核心结论:在 Ring 环形通信算法下,一次 AllReduce 在底层完全等价于一次 Reduce-Scatter 紧接一次 All-Gather: 其单步通信字节数关系为:
纯 TP 模式每 Block 通信量: 前向包含 2 次 AllReduce(Attention 输出 + MLP 输出):
TP + SP 模式每 Block 通信量: 前向包含 2 次 All-Gather(进入 Col Linear)+ 2 次 Reduce-Scatter(退出 Row Linear):
重要结论:!两者的通信总量完全相等。
- 虽然网络操作次数翻倍(从 2 次大包变成 4 次半包),但通信数据量被严格均摊。
- 在机内高速 NVLink 环境下,多出发射两次小集合通信的延迟开销(约 )微乎其微。
- 作为回报,模型所有非 TP 区域的驻留激活显存被直接消减了 倍(例如 8 卡下直接砍掉 87.5% 激活显存)。
具体演示与数值推演
以一个 70B 模型(隐藏层维度 ,层数 ),在 、序列长度 (16k 上下文)、单卡批次 (BF16 精度,每元素 2 字节)下的单层驻留激活为例:
未开启 SP(原生 TP-only): 每个 Block 内的 LayerNorm 与 Dropout 输入张量必须完整物化,单层静态驻留激活为: 全网 80 层累加的静态常驻激活高达: 在 80GB 显卡上,仅这部分未切分的冗余激活就吃掉了超过四分之一的宝贵显存空间。
开启 SP(TP + SP 协同): LayerNorm 与 Dropout 的输入切为 ,单层驻留激活降为: 80 层累计驻留激活仅需约 !直接省出近 显存,足以容纳更长的上下文或成倍增加训练 Batch Size。
代码填空题
模拟一个 transformer block 内激活形状 (s, h) 的变化,比较 TP-only 与 TP+SP 的峰值激活。
Code
def trace_block(
    seq: int, hidden: int, tp: int, enable_sp: bool, batch: int = 1,
) -> list[tuple[str, int, int]]:
    """
    返回 [(区域名, s, h)]:前向经过 block 时激活形状的轨迹(每 token 两字节 BF16 可算字节数)。

    算子表(对 (s, h) 的作用):
      split_seq    : s -> s/tp      (SP 区入口 / g* 出口)
      gather_seq   : s -> s*tp      (g:SP -> TP)
      split_hidden : h -> h/tp      (col-linear 切 h)
      gather_hidden: h -> h*tp      (row-linear 恢复 h)
      noop         : 不变

    区域顺序:
      layernorm → col_linear → gelu → row_linear → dropout
    """
    def split_seq(s, h): return (s // tp, h)
    def gather_seq(s, h): return (s * tp, h)
    def split_hidden(s, h): return (s, h // tp)
    def gather_hidden(s, h): return (s, h * tp)
    def noop(s, h): return (s, h)

    region_ops = {
        "layernorm": ______,   # 填空:TP-only 下 LN 输入就是全量 (s,h),用什么算子?
        "col_linear": ______,  # 填空:col-linear 沿隐藏维切分
        "gelu": ______,        # 填空:逐元素,形状不变
        "row_linear": ______,  # 填空:row-linear 恢复隐藏维
        "dropout": ______,     # 填空:TP-only 下 dropout 保持全量
    }
    sp_ops = {
        # 启用 SP 时各区域用的算子(提示:LN/dropout 在 SP 区沿序列切,
        # col/row 在 TP 区沿隐藏维切)
        "layernorm": ______,
        "col_linear": ______,
        "gelu": ______,
        "row_linear": ______,
        "dropout": ______,
    }
    plan = sp_ops if enable_sp else region_ops

    s, h = seq, hidden
    trace = []
    for name, op in plan.items():
        if enable_sp and name == "col_linear":
            # SP -> TP 过渡:g = all-gather 沿序列维,恢复完整 s
            s, h = gather_seq(s, h)
            trace.append(("g (all-gather seq)", s, h, False))   # 瞬态通信缓冲
        s, h = op(s, h)
        # SP 模式下 row-linear 的 (s, h) 输出是瞬态(随后被 g* 切回序列分片),
        # 反向真正需要的是它的输入(上一区域的 (s, h/tp))——所以标记为不驻留。
        persists = not (enable_sp and name == "row_linear")
        trace.append((name, s, h, persists))                    # 驻留激活(要存给反向)
        if enable_sp and name == "row_linear":
            trace.append(("row_out (full h)", s, h, False))      # 瞬态:随后被 g* 切回
            s, h = split_seq(s, h)
            trace.append(("g* (reduce-scatter seq)", s, h, False))
    return trace

def max_activation_bytes(trace: list[tuple[str, int, int, bool]], batch: int) -> int:
    """
    峰值【驻留】激活 = max(需要保存给反向的激活字节数),BF16 每元素 2 字节。
    g/g* 与 row_out 是瞬态全量张量(存在通信/临时缓冲区里),不计入驻留激活;
    但它们会出现在峰值显存里——面试时要主动区分"驻留激活"与"瞬态缓冲"。
    """
    return max(
        ______   # 填空:只统计驻留条目 (stored=True),b*s*h*2
        for name, s, h, stored in trace
        if stored
    )

def bf16_bytes(s: int, h: int, batch: int) -> int:
    return batch * s * h * 2

if __name__ == "__main__":
    seq, hidden, tp, bs = 4096, 4096, 8, 1

    t_tp = trace_block(seq, hidden, tp, enable_sp=False, batch=bs)
    t_sp = trace_block(seq, hidden, tp, enable_sp=True, batch=bs)

    print("TP-only:")
    for name, s, h, stored in t_tp:
        tag = " " if stored else "*"
        print(f"  {tag}{name:22s} s={s:5d} h={h:5d}  {bf16_bytes(s, h, bs)/1e6:8.1f} MB")
    print("TP+SP(* = 瞬态全量,不计入驻留激活):")
    for name, s, h, stored in t_sp:
        tag = " " if stored else "*"
        print(f"  {tag}{name:26s} s={s:5d} h={h:5d}  {bf16_bytes(s, h, bs)/1e6:8.1f} MB")

    m_tp = max_activation_bytes(t_tp, bs)
    m_sp = max_activation_bytes(t_sp, bs)
    print(f"\nTP-only 峰值 = {m_tp/1e6:.1f} MB = b·s·h·2 = {bs*seq*hidden*2/1e6:.1f} MB")
    print(f"TP+SP   峰值 = {m_sp/1e6:.1f} MB = b·s·h·2/tp = {bs*seq*hidden*2/tp/1e6:.1f} MB")
    assert m_sp * tp == m_tp
    print("验证:TP+SP 峰值激活 = TP-only 的 1/tp ✓")
三个问答题
Q1
为什么 LayerNorm 不能像 MLP 那样沿隐藏维切分?请写出 LayerNorm 公式并指出哪一步依赖完整 h。dropout 为什么也需要 SP(提示:随机掩码的模式)?
Q2
教材用 f/f* 描述 TP 区域与 DP 的交界、用 g/g* 描述 SP 与 TP 区域的交界。请分别写出前向和反向下 f、f* 各是什么操作(no-op 还是 all-reduce),并解释为什么反向恰好互换。SP 区域为什么刻意不用 all-reduce?
Q3
教材说 TP+SP “通信操作数是 TP 的两倍(2 all-gather + 2 reduce-scatter vs 2 all-reduce),但总通信量等价”。请用第 3 课的结论(all-reduce = reduce-scatter + all-gather)证明这一点,并指出这为什么使 SP 几乎免费。
检查与通过标准
总分 10 分:代码正确 4 分(变换计划、g/g* 过渡、峰值公式与验证)、三题各 2 分、通过线 8 分。
一票否决项:
- 把 SP 与 CP 混为一谈(本书定义下)。
- 认为 SP 沿隐藏维切分 LayerNorm 的输入。
- 说不出 g* 是 reduce-scatter(把 row-linear 的求和与序列切分合并)或方向错误。
- 声称 SP 增加了通信量(而非通信次数增加、总量等价)。