---
title: "第 3 课:策略梯度与基线"
jupyter: python3
---
::: {.callout-note appearance="simple"}
**参考答案版**:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
:::
## 本课目标与完成标准
学完后你应能:从 log-derivative trick 解释 REINFORCE,并实现不改变期望梯度的 baseline advantage。
通过必须同时满足:
- 独立补齐本课唯一的代码填空题,并通过给定检查;
- 三个问答题均说明因果链,而不是只报术语;
- 能指出至少一个正确性边界和一个性能取舍;
- 总分不低于 8/10,且没有一票否决级概念错误。
## 前置关系
- 课程前置:Python、概率期望、基本深度学习
- 本课在路线中的作用:策略梯度直接提高高回报动作的对数概率;baseline 只降低方差,不应依赖当前采样动作。
## 核心心智模型
### 1. 它是什么,解决什么问题
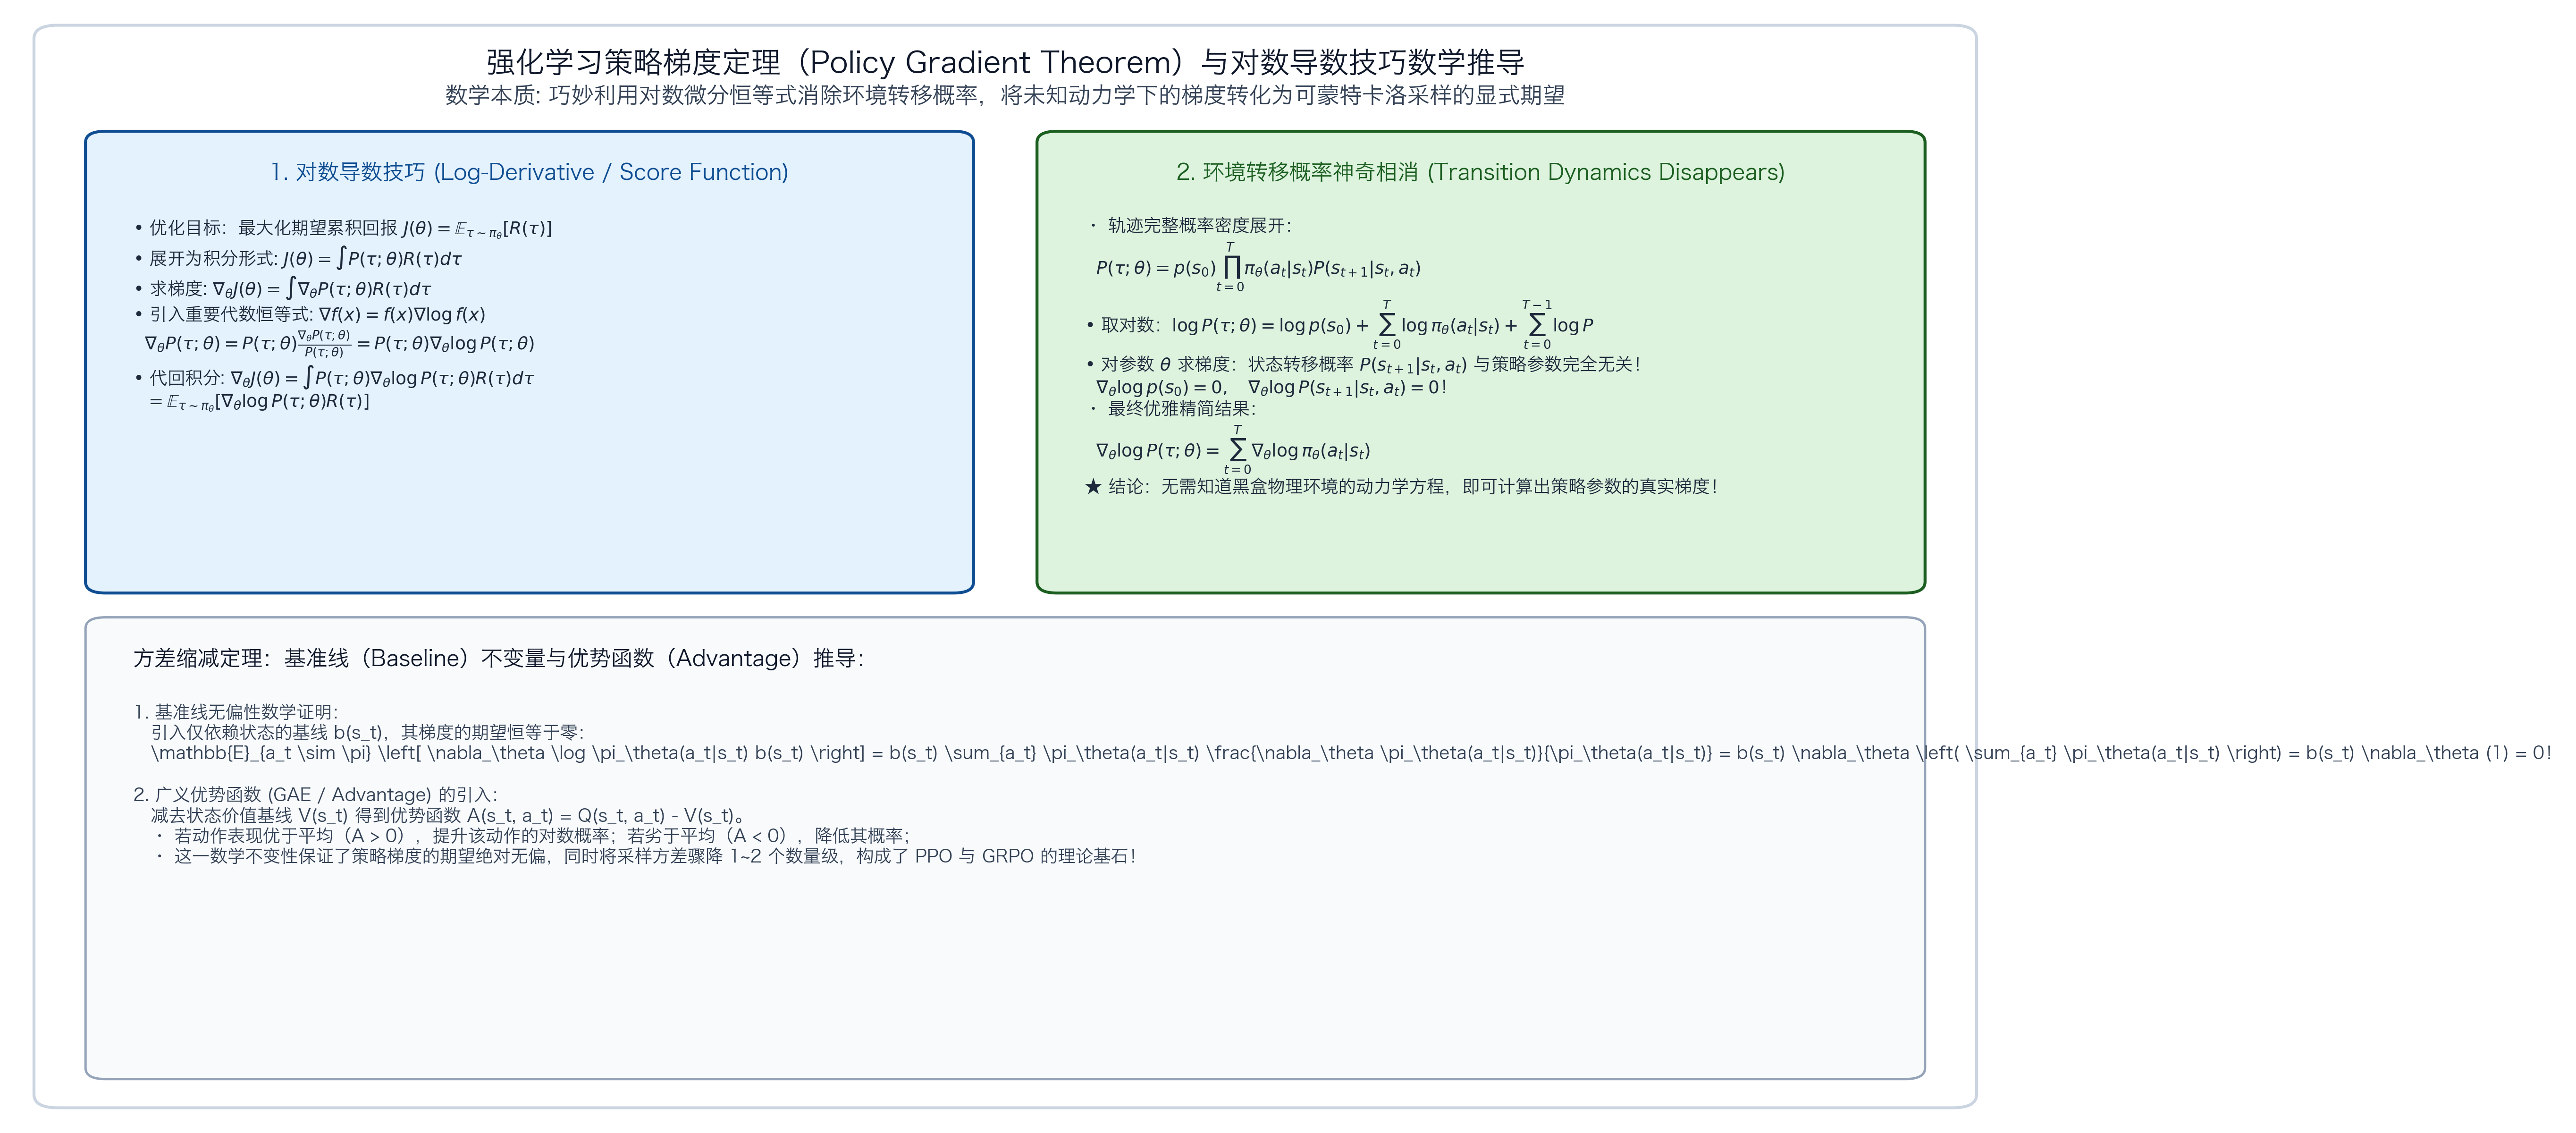
策略梯度定理(Policy Gradient Theorem)与似然比技巧(Likelihood Ratio Trick / Log-derivative Trick)是现代策略优化(Policy Optimization)与大模型后训练(RLHF / PPO / GRPO)的数学核心。
在环境动力学 $\mathcal{P}(s' \mid s, a)$ 未知且物理不可导、且动作采样操作离散不可导的前提下,我们定义全局优化目标为期望总回报:
$$ \mathcal{J}(\theta) = \mathbb{E}_{\tau \sim \pi_\theta} [R(\tau)] = \int P(\tau; \theta) R(\tau) d\tau $$
直接对其求导,应用微积分恒等式 $\nabla_\theta P(\tau; \theta) = P(\tau; \theta) \nabla_\theta \log P(\tau; \theta)$,将导数重新转化为对当前策略采样轨迹的数学期望:
$$ \nabla_\theta \mathcal{J}(\theta) = \mathbb{E}_{\tau \sim \pi_\theta} \left[ \sum_{t=0}^{T-1} \nabla_\theta \log \pi_\theta(a_t \mid s_t) \cdot G_t \right] $$
它解决的核心工程问题是:
1. **黑盒与离散动作空间的梯度反传问题**:现实环境和神经自回归解码中的离散 Token 采样在数学上均不可导。似然比技巧绕过了对采样操作符的直接微分,转而对生成该动作的对数概率 $\log \pi_\theta(a \mid s)$ 求导,并以标量回报 $G_t$ 作为权重缩放梯度——使得回报高于平均的动作被鼓励提高概率,回报低于平均的动作被抑制;
2. **蒙特卡洛方差爆炸与基线减方差(Variance Reduction via Baseline)**:纯 REINFORCE 依赖长轨迹的真实累积回报 $G_t$ 作为权重,方差随序列长度成平方级爆炸。通过引入仅依赖于状态而独立于当前动作的基线 $b(s)$,构造优势函数 $A_t = G_t - b(s)$,在严格保证期望梯度数学无偏的前提下,大幅削减了估计方差。
### 2. 它如何工作
策略梯度数据流拓扑与训练循环如图 3-1 至图 3-3 所示:
::: {.img-card}
{width="95%"}
<p class="caption">图 3-1:强化学习策略梯度定理(Policy Gradient Theorem)与对数导数技巧数学推导</p>
:::
1. **基线减方差数据流(图 3-2)**:
```{mermaid}
flowchart LR
    State["输入观测 s"] --> PolicyNet["策略网络 π_θ(a|s)"]
    PolicyNet --> Sample["采样动作 a ~ π_θ"]
    Sample --> Env["环境反馈回报 G_t"]
    State --> BaselineNet["价值基线网络 V_ϕ(s)"]
    Env & BaselineNet --> Adv["优势权重: A_t = G_t - V_ϕ(s) (大幅缩减方差)"]
    Adv & PolicyNet --> Grad["∇J(θ) = E[∇log π_θ(a|s) * A_t]"]
```
<p class="caption" align="center"><em>图 3-2:策略梯度定理与状态基线 (Baseline) 减方差数据流</em></p>
- 策略网络 $\pi_\theta(a \mid s)$ 接收状态 $s$,输出动作概率分布并采样得到具体动作 $a \sim \pi_\theta$。环境交互产出折现回报 $G_t$;
- 状态价值网络(Critic)预测状态预期基准 $V_\phi(s)$(或通过 RLOO 计算留一组均值),合成中心化优势权重:
$$ A_t = G_t - V_\phi(s) $$
- **基线无偏性严格数学证明**:
$$ \mathbb{E}_{a \sim \pi_\theta} \left[ \nabla_\theta \log \pi_\theta(a \mid s) \cdot b(s) \right] = b(s) \sum_{a \in \mathcal{A}} \pi_\theta(a \mid s) \frac{\nabla_\theta \pi_\theta(a \mid s)}{\pi_\theta(a \mid s)} = b(s) \nabla_\theta \sum_{a \in \mathcal{A}} \pi_\theta(a \mid s) = b(s) \nabla_\theta (1) = 0 $$
这证明:任何与当前动作 $a$ 条件独立的基线 $b(s)$,其对策略梯度的期望贡献严格等于零!因此,从回报中扣除基线**绝对不会歪曲梯度方向,仅大幅消除不同状态间固有的均值偏移方差**。
2. **REINFORCE 完整闭环流水线(图 3-3)**:
```{mermaid}
flowchart TD
    Init["初始化策略网络 π_θ 与价值基线 V_ϕ"] --> Rollout["收集多条交互轨迹 Episode 集合"]
    Rollout --> ComputeReturn["逆序计算各步累积回报 G_t"]
    ComputeReturn --> ComputeAdv["计算中心化基线差值 A_t = G_t - V_ϕ(s_t)"]
    ComputeAdv --> UpdatePolicy["执行策略梯度上升更新 θ"]
    ComputeAdv --> UpdateValue["以 MSE 损失拟合基线更新 ϕ"]
```
<p class="caption" align="center"><em>图 3-3:REINFORCE 带基线策略梯度的完整迭代循环流程</em></p>
- Rollout 阶段收集批次交互轨迹,自后向前逆序计算每步折扣回报 $G_t = r_t + \gamma G_{t+1}$;
- 计算优势值 $A_t = G_t - V_\phi(s_t)$,并将其转化为代理策略损失函数:
$$ \mathcal{L}_{\text{policy}}(\theta) = - \frac{1}{B} \sum_{i=1}^B \sum_{t=0}^{T_i-1} A_{i, t} \cdot \log \pi_\theta(a_{i, t} \mid s_{i, t}) $$
- 同时利用均方误差损失更新价值网络 $\phi$:$\mathcal{L}_{\text{value}}(\phi) = \frac{1}{2B} \sum (V_\phi(s_{i,t}) - G_{i,t})^2$。
3. **大模型后训练中的 RLOO(REINFORCE Leave-One-Out)机制**:
在单轮 Prompt 生成大模型对齐中,完整回答 $y$ 的对数概率为联合累加:$\log \pi_\theta(y \mid x) = \sum_{t=1}^T \log \pi_\theta(y_t \mid x, y_{<t})$。
RLOO 针对同一 Prompt $x$ 独立并行生成 $K \ge 2$ 个完整回答,各自获得标量奖励 $R_1, \dots, R_K$。针对第 $i$ 个回答,剔除自身后的其余 $K-1$ 个样本均值构成其专属状态基线:
$$ b_i = \frac{1}{K-1} \sum_{j \neq i} R_j, \quad A_i^{\text{RLOO}} = R_i - b_i $$
由于其余样本与当前第 $i$ 次采样的具体 Token 严格条件独立,RLOO 在零 Critic 训练成本的前提下实现了严格无偏的方差归约。
### 3. 正确性条件与常见误区
- **优势权重必须阻断反传(Stop-Gradient / Detach)**:
在深度学习实现中,损失定义为 $-\text{mean}(A \cdot \log \pi)$。此时优势张量 $A_t$(无论是 $G_t - V(s)$ 还是 $R_i - b_i$)**必须严格执行 `detach()`**。如果允许梯度反向穿透到计算优势的节点中,反向传播将把优化目标篡改为“修改策略使基线变小”,导致网络陷入病态梯度崩塌。
- **全局均值基线的自相关有偏陷阱**:
若在计算基线时图省事直接使用包含自身的组均值 $\bar{R} = \frac{1}{K} \sum_{j=1}^K R_j$,并将优势定义为 $A_i = R_i - \bar{R}$:
$$ A_i = R_i - \frac{1}{K} \left( R_i + \sum_{j \neq i} R_j \right) = \frac{K-1}{K} \left( R_i - \frac{1}{K-1} \sum_{j \neq i} R_j \right) = \frac{K-1}{K} A_i^{\text{RLOO}} $$
此时基线与当前动作强相关,违反了基线独立性假设。虽然形式上相似,但如果不进行方差标准化,梯度期望会被系统性人为收缩 $\frac{K-1}{K}$ 倍,造成等效学习率剧烈萎缩。
- **Masking 掩码泄露(Prompt / Padding 污染)**:
在自回归 LLM 训练中,损失求和必须严格只对模型自主生成的有效 Token 施加掩码($m_{it} = 1$),必须坚决剔除 Prompt Token 与尾部 Padding Token。若对 Prompt 计算策略梯度,相当于对固定的环境输入状态进行错误概率更新,导致模型自注意力层发生严重语义漂移。
### 4. 性能与工程取舍
- **训练专用 Critic vs 纯采样 RLOO**:
- **Critic 模式(PPO / A2C)**:可输出 Token 级的密集细粒度优势估值,单 Prompt 仅需采样 1 条轨迹即可更新;但需维护单独的 Critic 权重(占满同等显存),且面临 Critic 价值漂移和拟合延迟带来的误差;
- **RLOO 模式**:完全无需训练 Critic 模型,显存占用直降 50%,无价值网络过拟合或自举漂移问题;但代价是每个 Prompt 必须生成至少 $K \ge 2$(通常推荐 $K=4 \sim 8$)条回答,推理解码(Rollout)吞吐压力成倍增加。
- **序列级别长度均一化(Length Normalization Trade-off)**:
联合对数概率 $\sum_{t=1}^T \log \pi(y_t)$ 会随文本长度线性累加,导致长文本回答在批次中主导梯度更新。若将其除以生成长度 $T$ 转化为平均对数概率,虽能平抑梯度范数,但在数学上相当于对不同长度回答的隐式重加权,可能诱导模型产生“偏好短文本避错”的短视倾向。
## 具体演示:RLOO 留一基线与包含自身均值的数值差异
假设针对同一个输入 Prompt,独立解码采样出 3 个候选回答,环境奖励模型给出的奖励分别为 $[3.0, 1.0, 2.0]$:
- **方案 A(RLOO 留一无偏基线)**:
- 对样本 0:基线 $b_0 = \frac{1.0 + 2.0}{2} = 1.5 \implies A_0 = 3.0 - 1.5 = +1.5$;
- 对样本 1:基线 $b_1 = \frac{3.0 + 2.0}{2} = 2.5 \implies A_1 = 1.0 - 2.5 = -1.5$;
- 对样本 2:基线 $b_2 = \frac{3.0 + 1.0}{2} = 2.0 \implies A_2 = 2.0 - 2.0 = 0.0$;
- 输出优势向量为 $[+1.5, -1.5, 0.0]$,优势总和严格为 0,且每个基线与当前样本无相关性。
- **方案 B(包含自身的全局均值基线)**:
- 全局均值 $\bar{R} = \frac{3.0 + 1.0 + 2.0}{3} = 2.0$;
- 得到优势 $[3.0 - 2.0, 1.0 - 2.0, 2.0 - 2.0] = [+1.0, -1.0, 0.0]$;
- 对比可见,方案 B 计算出的优势值刚好是真实无偏 RLOO 优势的 $\frac{K-1}{K} = \frac{2}{3}$,使得策略梯度更新步长被凭空压缩了 33.3%。
## 实践任务:唯一代码填空题
补齐 REINFORCE 的单批损失;输入是已采样动作的 log_prob 和 detached return。
规则:只能修改 `TODO`/`______` 所在位置;不要删除断言或放宽误差。代码注释说明了每个边界条件。
```{python}
#| course_role: exercise
def reinforce_loss(log_probs, returns):
    """log_probs 为动作/序列 log-prob,returns 为冻结的优势或回报。"""
    if not log_probs or len(log_probs) != len(returns):
        raise ValueError("need nonempty aligned samples")
    # TODO:只补齐下面这个表达式。
    return ______

assert reinforce_loss([-0.2, -0.7], [2.0, 1.0]) == 0.55

# 已给出的 RLOO baseline;唯一填空仍是上面的 REINFORCE 损失。
def rloo_advantages(rewards):
    if len(rewards) < 2:
        raise ValueError("RLOO needs at least two independent completions")
    total = sum(rewards)
    return [r - (total - r) / (len(rewards) - 1) for r in rewards]

assert rloo_advantages([3., 1., 2.]) == [1.5, -1.5, 0.]
assert rloo_advantages([2., 2.]) == [0., 0.]
centered = [r - 2. for r in [3., 1., 2.]]
assert all(abs(a - 2/3*b) < 1e-12
           for a, b in zip(centered, rloo_advantages([3., 1., 2.])))
assert abs(reinforce_loss([-.9], [2.]) - 1.8) < 1e-12
assert reinforce_loss([-.9], [0.]) == 0.
for bad in [[], [1.]]:
    try:
        rloo_advantages(bad)
    except ValueError:
        pass
    else:
        raise AssertionError("undersized RLOO group must fail")
for logps, returns in [([], []), ([1.], [])]:
    try:
        reinforce_loss(logps, returns)
    except ValueError:
        pass
    else:
        raise AssertionError("unaligned or empty batch must fail")
```
### 检查方法
运行本单元格;所有 `assert` 必须通过。另手工构造一个边界输入,解释预期结果。
提交时请给出:补齐后的代码、实际运行输出(环境不可用时注明“仅静态审查”)以及对失败用例的解释。
### Q1
不要背定义:请从输入、状态变化和输出三个阶段解释“策略梯度与基线”的工作机制。
**你的答案:**
### Q2
若直接把概率 π 而不是 logπ 乘回报,梯度估计哪里变了?
**你的答案:**
### Q3
共享 backbone 的 actor-critic 中,如何检查两个 loss 的梯度是否互相破坏?
**你的答案:**
## 评分与通过规则
- 代码 4 分:正常输入 2 分,边界输入 1 分,解释实现 1 分;
- Q1~Q3 各 2 分;
- 一票否决:结果碰巧正确但核心因果链错误、删除边界检查、把未运行结果说成实测。
需要提示时按四级机制请求:概念区域 → 具体方向 → 关键局部 → 完整答案。
::: {.callout-tip collapse="true" title="💡 点击展开参考答案与详细代码实现" icon="false"}
## 参考答案(仅 answer 分支)
先完成题目再核对。即使代码一致,也要能解释关键步骤,并尝试更换一个输入规模。
```{python}
#| course_role: solution
def reinforce_loss(log_probs, returns):
    """log_probs 为动作/序列 log-prob,returns 为冻结的优势或回报。"""
    if not log_probs or len(log_probs) != len(returns):
        raise ValueError("need nonempty aligned samples")
    # 参考实现:表达式直接对应上文不变量。
    return -sum(lp * ret for lp, ret in zip(log_probs, returns)) / len(log_probs)

assert reinforce_loss([-0.2, -0.7], [2.0, 1.0]) == 0.55

# 已给出的 RLOO baseline;唯一填空仍是上面的 REINFORCE 损失。
def rloo_advantages(rewards):
    if len(rewards) < 2:
        raise ValueError("RLOO needs at least two independent completions")
    total = sum(rewards)
    return [r - (total - r) / (len(rewards) - 1) for r in rewards]

assert rloo_advantages([3., 1., 2.]) == [1.5, -1.5, 0.]
assert rloo_advantages([2., 2.]) == [0., 0.]
centered = [r - 2. for r in [3., 1., 2.]]
assert all(abs(a - 2/3*b) < 1e-12
           for a, b in zip(centered, rloo_advantages([3., 1., 2.])))
assert abs(reinforce_loss([-.9], [2.]) - 1.8) < 1e-12
assert reinforce_loss([-.9], [0.]) == 0.
for bad in [[], [1.]]:
    try:
        rloo_advantages(bad)
    except ValueError:
        pass
    else:
        raise AssertionError("undersized RLOO group must fail")
for logps, returns in [([], []), ([1.], [])]:
    try:
        reinforce_loss(logps, returns)
    except ValueError:
        pass
    else:
        raise AssertionError("unaligned or empty batch must fail")
```
### Q1 参考答案
1. **输入阶段(探索采样与价值基准获取)**:输入由策略网络 $\pi_\theta$ 与环境交互采样的动作及对应的对数概率序列 $\log \pi_\theta(a_t \mid s_t)$、外部环境或奖励模型给出的折现累积回报序列 $G_t$(或单轮 LLM 生成的标量奖励 $R_i$)、以及状态基线估值 $b(s_t)$(由 Critic 网络前向预测或 RLOO 组内留一均值生成)。
2. **状态变化阶段(优势居中化与目标函数微分)**:
- **消除基准偏移(优势构造)**:计算中心化优势 $A_t = G_t - b(s_t)$。由于 $b(s_t)$ 与当前采样的具体动作条件独立,根据积分恒等式 $\mathbb{E}_{a \sim \pi} [\nabla_\theta \log \pi_\theta(a \mid s) \cdot b(s)] = 0$,从回报中扣除基准完全不会改变策略梯度的无偏期望,但将方差大幅压缩;
- **反向传播与对数概率加权**:优势项 $A_t$ 必须被严格冻结梯度(`stop_gradient` / `detach()`)。通过损失函数 $\mathcal{L}_{\text{policy}} = - \frac{1}{B} \sum A_t \log \pi_\theta(a_t \mid s_t)$ 反向传播,网络权重沿着 $\nabla_\theta \mathcal{J} = \mathbb{E}[\nabla_\theta \log \pi_\theta(a \mid s) \cdot A_t]$ 移动:当动作表现优于基线($A_t > 0$)时,主动提升该动作的选择概率;表现劣于基线($A_t < 0$)时,主动抑制其概率。
3. **输出阶段(策略更新与方差收缩)**:输出更新后的策略参数 $\theta$,实现动作分布的单调性能提升。通过基准中心化消除环境固有状态价值均值波动的干扰,使策略更新方向高度对齐于“动作本身的相对优劣”,保障深度神经网络在随机非平稳奖励下的收敛稳定性。
### Q2 参考答案
若错误地用概率 $\pi_\theta(a \mid s)$ 替代对数概率 $\log \pi_\theta(a \mid s)$ 乘以回报,梯度估计将发生严重的**采样分布重叠偏置(Double-Sampling Probability Bias)**,彻底丧失 REINFORCE 的数学无偏性:
1. **数学推导失真**:真实的策略梯度来自于似然比展开:
$$ \nabla_\theta \mathbb{E}_\pi [R] = \sum_a \nabla_\theta \pi_\theta(a \mid s) R(s, a) = \sum_a \pi_\theta(a \mid s) \frac{\nabla_\theta \pi_\theta(a \mid s)}{\pi_\theta(a \mid s)} R(s, a) = \mathbb{E}_{a \sim \pi} \left[ \nabla_\theta \log \pi_\theta(a \mid s) R(s, a) \right] $$
2. **错误方案的实际等效目标**:若直接用 $\nabla_\theta \pi_\theta(a \mid s) R(s, a)$ 对经验采样求均值,由于动作 $a$ 已经是按照 $\pi_\theta$ 分布采样出来的,该经验均值的期望实际为:
$$ \mathbb{E}_{a \sim \pi} \left[ \nabla_\theta \pi_\theta(a \mid s) R(s, a) \right] = \sum_a \pi_\theta(a \mid s) \cdot \nabla_\theta \pi_\theta(a \mid s) R(s, a) = \sum_a \pi_\theta^2(a \mid s) \nabla_\theta \log \pi_\theta(a \mid s) R(s, a) $$
3. **病态自增强收敛陷阱**:这相当于在原有真实梯度上,额外乘了一次动作概率 $\pi_\theta(a \mid s)$!高频、大概率动作获得的有效学习率被二次放大,而低频但潜在高回报的探索动作被施加了平方级的极端抑制。算法将丧失基本的探索能力,迅速陷入对高初始概率次优动作的盲目病态过拟合,甚至导致策略过早熵崩溃。
### Q3 参考答案
在共享骨干网络(Shared Backbone)的 Actor-Critic 架构中,排查与验证两个损失(Policy Loss 与 Value Loss)是否发生负向梯度冲突的标准工程方案如下:
1. **梯度余弦相似度与范数监测(Gradient Cosine Conflict)**:
在反向传播前,对共享层参数 $W_{\text{shared}}$ 分别独立计算关于策略损失 $\mathcal{L}_\pi$ 的梯度 $g_\pi = \nabla_{W} \mathcal{L}_\pi$ 与关于价值损失 $\mathcal{L}_V$ 的梯度 $g_V = \nabla_{W} \mathcal{L}_V$。计算二者的余弦相似度:
$$ \cos(g_\pi, g_V) = \frac{\langle g_\pi, g_V \rangle}{\|g_\pi\|_2 \cdot \|g_V\|_2} $$
- 若余弦相似度持续显著为负($\cos < 0$),确凿证明策略更新与价值拟合在底层表征空间发生对抗性破坏(Destructive Interference),即一个任务在拉扯参数改善动作分布的同时破坏了状态价值表征;
- 比较梯度范数比值 $\|g_\pi\|_2 / \|g_V\|_2$。若 Value Loss 的梯度范数高出 Policy Loss 数个数量级,说明价值拟合主导了整个表征更新,挤压了策略梯度的演进空间。
2. **消融对照与架构解耦诊断**:
- 使用相同的采样数据和批次,运行两套架构对比实验:一套为共享 Backbone(多任务头),另一套为 Actor 与 Critic 彻底解耦的独立双塔模型(Separate Models);
- 若独立双塔模型训练平稳收敛且回报持续攀升,而共享模型出现性能突降、Policy 熵过早归零或 Value 损失剧烈振荡,即可判定存在严重的梯度负迁移。
3. **工程解法**:
- 采用梯度投影正交化技术(如 PCGrad: Projecting Conflicting Gradients),当检测到 $\langle g_\pi, g_V \rangle < 0$ 时,将 $g_\pi$ 投影到 $g_V$ 的正交法平面,消除破坏性反向分量;
- 动态调整多任务损失系数 $\mathcal{L}_{\text{total}} = \mathcal{L}_\pi + c_v \mathcal{L}_V - c_e \mathcal{H}$ 中的 $c_v$,或在工业级大模型训练(如 DeepSeek-R1 / OpenAI PPO)中直接将 Actor 与 Critic 部署在不同的物理进程与独立模型上。
## 参考资料
- [Back to Basics / RLOO(§2.2–2.3)](https://arxiv.org/html/2402.14740v1)
论文实验结论有具体模型和任务范围,不据此断言 RLOO 总优于 PPO。
:::
::: {.course-pagination}
[**← 上一课**<br>第 2 课:Monte Carlo、TD 与...](lesson02_mc_td.qmd){.pagination-link .pagination-prev}
[**下一课 →**<br>第 4 课:GAE 与优势估计](lesson04_gae.qmd){.pagination-link .pagination-next}
:::
