---
title: "第 6 课:量化源码走读:INT4、FP8、NVFP4、MXFP4 与 KV Cache"
jupyter: python3
---
::: {.callout-note appearance="simple"}
**参考答案版**:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
:::
## 本课目标与通过标准
本课产出:能从 vLLM/SGLang quantization registry 追到 QuantizationConfig、layer method 与 kernel,并根据硬件、瓶颈和质量证据选择 W4A16、W8A8/FP8、FP4 或 KV 量化。
通过要求:唯一代码填空题通过全部断言;Q1~Q3 都能沿源码对象给出因果链;能指出一个正确性不变量、一个性能边界和一个需要 benchmark 才能确认的结论;总分至少 8/10。
## 源码版本与阅读方法
本课程使用固定 commit 的永久链接保证行号可复现,同时链接 current docs 供核对最新变化。阅读时先画调用图和状态所有权,再进入分支;不要从大文件第一行机械顺读。
源码阅读顺序:
1. vLLM `model_executor/layers/quantization/__init__.py`:`QuantizationMethods` 与 `get_quantization_config`。
2. vLLM `base_config.py`:`QuantizationConfig.get_quant_method` 与 `QuantizeMethodBase.create_weights/apply`。
3. vLLM `compressed_tensors/schemes/`:按 W4A16、W8A8 FP8、NVFP4、MXFP4 比较 scheme,不要只看文件名。
4. SGLang `layers/quantization/__init__.py`:平台条件下的 registry、CPU/外部平台 override。
5. SGLang `fp8.py`、`mxfp4.py`、`nvfp4_online.py`、`kv_cache.py`:追 checkpoint metadata 到实际 op。
源码快照:vLLM `8e958902eee5`;SGLang `9deb6952afa4`。
## 核心概念与运行机制
### 1. 它是什么,解决什么问题
在当代超大规模语言模型(LLM)的工业化部署中,全精度(FP16/BF16)模型面临着严峻的物理制约:
1. **显存容量瓶颈(VRAM Capacity Wall)**:一个 70B 参数的 BF16 模型仅权重就需要占据约 140 GB 显存,至少需要两张 80GB GPU 才能勉强加载,留给 KV Cache 和高并发并发批处理(Batch Size)的显存空间极其逼仄;
2. **访存带宽瓶颈(Memory Bandwidth Wall)**:在自回归 Decode 阶段,计算强度(FLOPs/Byte)极低,GPU 绝大部分时间都在等待从 HBM 中读取庞大的模型权重与长序列 KV Cache。
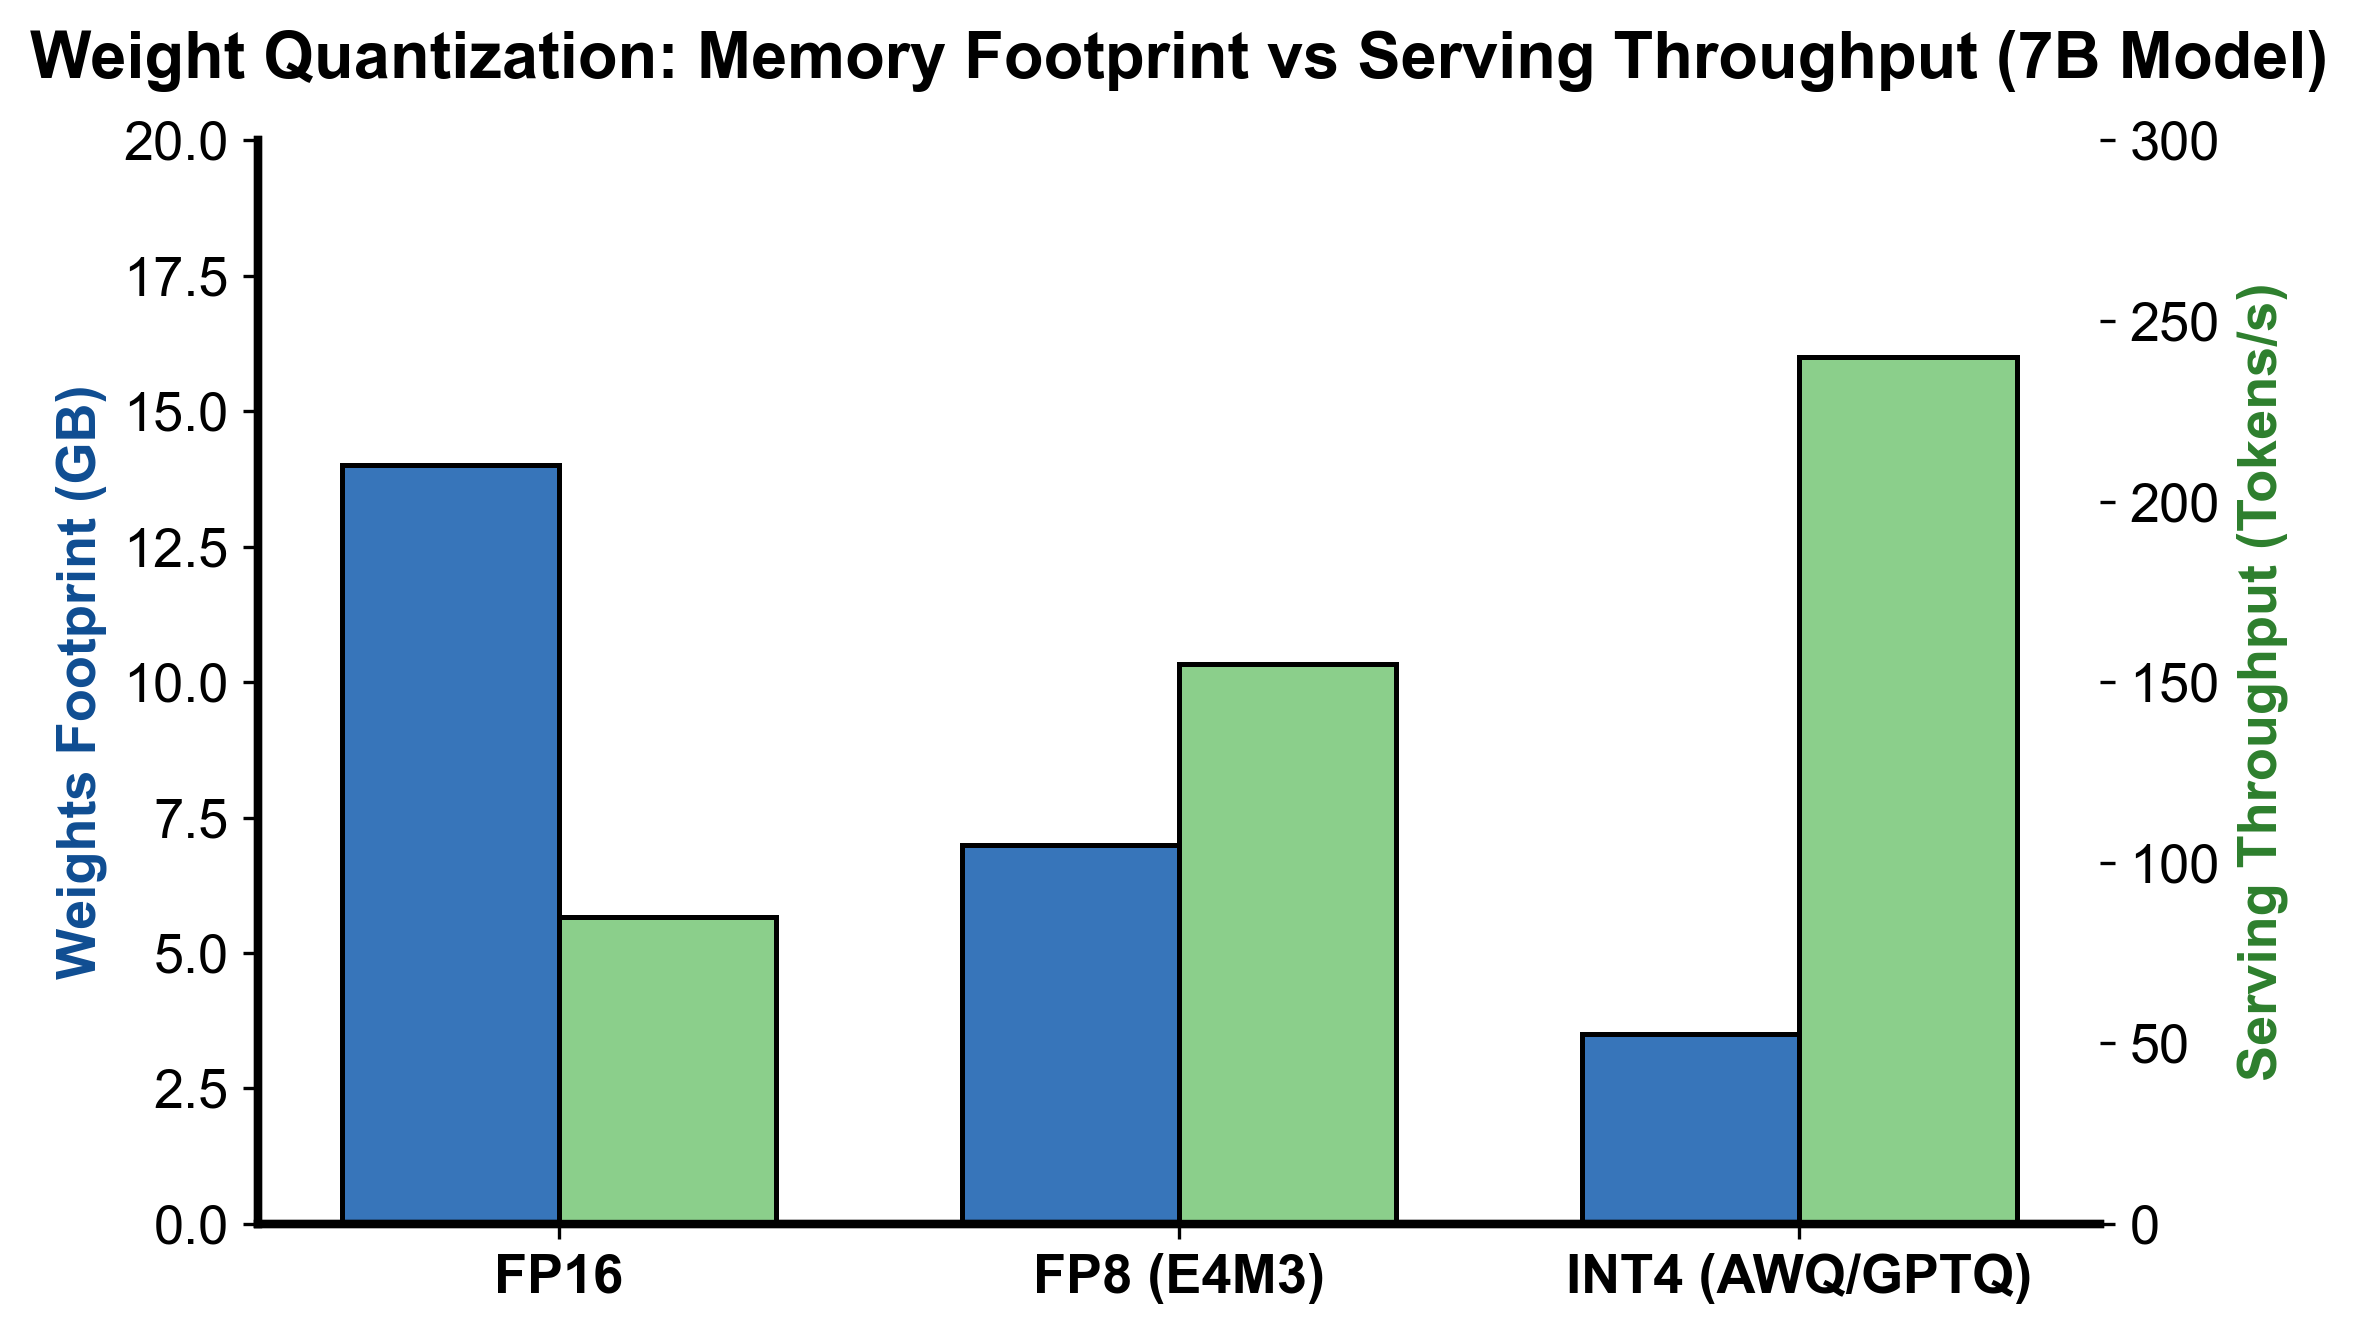
**模型量化(Model Quantization)**(如**图 6-1** 所示)通过将高精度浮点数映射到低比特离散数值空间
::: {.img-card}
{width="85%"}
<p class="caption">图 6-1:FP16 vs FP8 vs INT4 显存占用与推理吞吐权衡对比</p>
:::
(如 INT8、INT4、FP8、NVFP4、MXFP4),实现显存占用大幅缩减与访存/计算吞吐的数倍跃升。如图 6-1 所示,从 FP16 到 FP8 再到 INT4,模型显存占用可降低 50%~75%,为 KV Cache 腾出巨大的并发容量,同时推动系统吞吐成倍增长。
在现代高性能推理引擎(vLLM 与 SGLang)中,量化不仅仅是一套数学离散化算法,更是一套横跨 **权重存储打包(Packing)**、**运行时配置注册(Registry)**、**动态在线标定(Calibration)**与 **GPU 底层硬件算子分发(Kernel Dispatch)** 的完整系统工程。
### 2. 它如何工作
工业级推理引擎中的量化执行流水线具有严密的分层架构(如图 6-2 所示):
```{mermaid}
flowchart TD
    Act["输入激活 X (FP16/BF16)"] --> DynamicQuant["动态在线量化: X_quant = round(X / scale)"]
    Weight["低比特权重 W_quant (离线预量化)"] --> WeightLoad["从显存高效拉取压缩数据 (带宽翻倍)"]
    DynamicQuant & WeightLoad --> TensorCore["Tensor Core 硬件执行低精度点积 (INT4/FP8 GEMM)"]
    TensorCore --> ScaleMul["反量化乘缩放因子: Out = TensorCore * (scale_x * scale_w)"]
    ScaleMul --> Out["高精度写回 (FP16/BF16)"]
```
<p class="caption" align="center"><em>图 6-2:量化 GEMM 在线标定、Tensor Core 计算与反量化流水线</em></p>
1. **量化范式与精度矩阵**:
- **W4A16(权重量化,激活保持高精度)**:如 AWQ、GPTQ、Marlin。仅将静态权重压缩为 INT4 存放于 HBM,在 GEMM 算子内部流式反量化回 FP16/BF16 进行计算。核心收益是节省 75% 的权重显存带宽与容量,极度契合单请求或小 Batch 的 Decode 场景。
- **W8A8 / FP8(权重与激活双量化)**:利用现代 GPU(NVIDIA Ada/Hopper/Blackwell)原生的 FP8 Tensor Core(E4M3 用于前向计算,E5M2 用于梯度或长动态范围),在输入激活进入 GEMM 前执行动态在线量化:
$$\tilde{X} = \text{clip}\left(\text{round}\left(\frac{X}{s_x}\right), -q_{\max}, q_{\max}\right)$$
Tensor Core 直接执行原生的 8-bit 点积累加,吞吐比 FP16 翻倍。
- **NVFP4 / MXFP4(Micro-scaling 微缩放 4-bit 范式)**:传统 Per-Tensor 或 Per-Channel 量化在 4-bit 下极易因激活异常值(Outliers)导致全盘精度崩溃。NVFP4 与 OCP MXFP4 引入细粒度微块缩放(Micro-block Scaling,如每 16 或 32 个元素共享一个独立的 E2M1 浮点缩放因子),有效将 Outlier 限制在局部微块内,并在 Blackwell 原生 FP4 Tensor Core 上实现近乎 4 倍的计算吞吐。
- **KV Cache 量化**:独立于模型权重量化,针对长上下文场景将 Paged KV Cache 压缩为 FP8 或 INT4 格式,使单卡支持的上下文长度与最大并发量激增数倍。
2. **源码分层架构与生命周期**:
- **Registry 注册分发**:引擎启动时解析 `--quantization` 命令行参数与模型 `config.json`,在 `QuantizationRegistry` 中匹配对应的 `QuantizationConfig` 实现类;
- **层级注入与权重打包**:模型初始化时,`QuantizeMethodBase` 拦截模型的 `Linear` 或 `MoE` 算子,调用 `create_weights` 创建低精度 Packed 参数(如将 8 个 INT4 紧凑打包为一个 `int32`)与对应的 Scale/Zero-Point 张量;
- **权重重排(Layout Transformation)**:针对硬件 Tensor Core 的特定内存访问模式(如 Marlin 算子的 Interleaved 权重交织排列),在 `process_weights_after_loading` 中完成离线内存布局转换;
- **前向执行与算子分发**:运行时 `apply` 方法根据当前的 Batch 尺寸、序列长度与底层硬件 Capability,动态选择最优执行内核(如小 Batch 选择访存优化的 Marlin 内核,大 Batch 选择计算密集的 CUTLASS FP8 内核)。
### 3. 正确性条件与常见误区
- **数值范围溢出与不对称 Zero-Point 不变量**:
- 在对称量化(Symmetric Quantization)中,量化网格严格关于 0 对称:$X_q = \text{round}(X / s)$。若输入激活存在显著的单向分布偏移(如全部大于 0),对称量化会白白浪费一半的离散表达区间;
- 若采用非对称量化(Asymmetric Quantization),必须维护零点偏移量 $z$:$X_q = \text{round}(X / s) + z$。此时矩阵乘计算必须补偿与零点相关的交叉项,若反量化融合算子遗漏该交叉项,将引发致命的数值偏置与累积误差。
- **微块缩放(Micro-Scaling)的内存对齐与布局约束**:
- NVFP4 / MXFP4 的微块大小(如 16 或 32)要求矩阵的 $K$ 维度和 $N$ 维度必须是微块尺寸的整数倍。若模型存在非对齐的隐藏层维度(如某些特殊 Vocab Size 或 SwiGLU 中间层),必须执行 Padding 填充或特殊边界处理,否则将导致非法显存越界访问。
- **“显存占用直接除以量化比率”的伪常识**:
- *常见误区*:误以为将 16-bit 模型量化为 4-bit,整机显存消耗就必定降为原来的 $1/4$。
- *实际情况*:显存账本不仅包含模型权重,还包含庞大的 KV Cache 显存池、CUDA Graphs 预捕获显存空间、激活工作区(Workspace)、未量化的 Embedding/LM-Head 浮点张量、以及量化引入的额外 Scale/Zero-Point 元数据张量。
### 4. 性能与工程取舍
- **W4A16 vs. W8A8 (FP8) 的适用边界**:
- **W4A16** 适合**小 Batch(并发数 $\le 8$)的自回归 Decode**。此时系统处于严重的访存带宽瓶颈,减小权重体积即可线性降低权重拉取时间;但由于激活仍为高精度,Tensor Core 无法启用低精度计算单元,在大 Batch Prefill 下无法提供算力加速。
- **W8A8 (FP8)** 适合**大 Batch 吞吐优先或长 Prompt 的 Prefill 场景**。此时系统进入计算受限(Compute-Bound)区间,FP8 Tensor Core 提供的 2 倍峰值算力可显著压缩 TTFT,但在极小 Batch 下由于权重体积大于 INT4,访存延迟反而略逊于 W4A16。
- **动态量化(Dynamic Quant) vs. 静态标定(Static Quant)**:
- 动态在线量化每次前向实时计算激活张量的最大绝对值并推导 Scale,精度极高且无需离线校准集;但代价是引入了规约(Reduction)Kernel 的额外执行时延与显存同步。
- 静态标定使用离线数据集提前计算固定的 Scale,运行时零额外计算开销;但在遭遇分布外(OOD)提示词或极端 Outliers 时极易产生严重截断误差。
## 具体演示
设输入激活微块为包含 4 个元素的向量:$X = [0.0, 1.0, -2.0, 8.0]$,采用对称量化映射到 3-bit 有符号整数空间 $[-q_{\max}, q_{\max}]$,其中 $q_{\max} = 7$:
1. **计算绝对值最大值**:$\max(|X|) = \max([0.0, 1.0, 2.0, 8.0]) = 8.0$;
2. **计算缩放因子**:$s = \frac{\max(|X|)}{q_{\max}} = \frac{8.0}{7} \approx 1.142857$;
3. **执行整型量化与截断**:
$$q_0 = \text{round}(0.0 / s) = 0$$
$$q_1 = \text{round}(1.0 / (8/7)) = \text{round}(0.875) = 1$$
$$q_2 = \text{round}(-2.0 / (8/7)) = \text{round}(-1.75) = -2$$
$$q_3 = \text{round}(8.0 / (8/7)) = 7$$
量化整型向量为 $Q = [0, 1, -2, 7]$;
4. **反量化还原**:
$$\hat{X} = Q \times s = [0 \times \frac{8}{7}, 1 \times \frac{8}{7}, -2 \times \frac{8}{7}, 7 \times \frac{8}{7}] = [0.0, 1.143, -2.286, 8.0]$$
最大值 $8.0$ 得到精确无损表达,局部较小数值产生微小的舍入误差。若采用更细粒度的 2 元素微块,误差将被进一步局限和稀释。
## 实践任务:唯一代码填空题
补齐对称 micro-block fake quantization。它用于理解 scale 粒度,不冒充 NVFP4/MXFP4 的完整格式实现。
只能修改 `TODO`/`______` 位置,不得删除断言或放宽通过条件。
```{python}
#| course_role: exercise
def blockwise_symmetric_fake_quant(values, block_size, qmax):
    if block_size <= 0 or qmax <= 0:
        raise ValueError("invalid quantization geometry")
    restored, scales = [], []
    for start in range(0, len(values), block_size):
        block = values[start:start + block_size]
        max_abs = max((abs(x) for x in block), default=0.0)
        # TODO:零 block 使用 scale=1;其他 block 映射到 [-qmax,qmax]。
        scale = ______
        scales.append(scale)
        for value in block:
            q = ______
            restored.append(q * scale)
    return restored, scales

restored, scales = blockwise_symmetric_fake_quant([0.0, 1.0, -2.0, 8.0], 2, 7)
assert scales == [1/7, 8/7]
assert abs(restored[1] - 1.0) < 1e-12
assert abs(restored[-1] - 8.0) < 1e-12
assert blockwise_symmetric_fake_quant([0.0, 0.0], 2, 7) == ([0.0, 0.0], [1.0])
```
### 检查方法
运行断言;把 block size 改为 4,比较数值误差和 scale 数。说明该模型遗漏了真实 FP4 的哪些编码细节。
### Q1
从 `--quantization` 到实际 GEMM kernel,中间至少经过哪些源码层?
**你的答案:**
### Q2
为什么不能笼统地说“NVFP4 比 INT4 先进,所以一定更好”?
**你的答案:**
### Q3
模型量化后权重显存减半,但最大并发只提升 10%,应如何做账和定位?
**你的答案:**
## 评分规则
- 代码 4 分:主路径 2 分、边界条件 1 分、能映射回源码对象 1 分;
- Q1~Q3 各 2 分:必须包含对象、状态变化、正确性或成本链;
- 一票否决:把论文峰值写成普遍生产结论;把源码支持写成所有模型/硬件可用;混淆算法正确性与性能;只背类名而说不清状态所有权。
::: {.callout-tip collapse="true" title="💡 点击展开参考答案与详细代码实现" icon="false"}
## 参考答案(仅 answer 分支)
先独立完成。核对后请更换一个 batch、cache 或硬件条件重新推演,不能只复制。
```{python}
#| course_role: solution
def blockwise_symmetric_fake_quant(values, block_size, qmax):
    if block_size <= 0 or qmax <= 0:
        raise ValueError("invalid quantization geometry")
    restored, scales = [], []
    for start in range(0, len(values), block_size):
        block = values[start:start + block_size]
        max_abs = max((abs(x) for x in block), default=0.0)
        scale = max_abs / qmax if max_abs else 1.0
        scales.append(scale)
        for value in block:
            q = max(-qmax, min(qmax, round(value / scale)))
            restored.append(q * scale)
    return restored, scales

restored, scales = blockwise_symmetric_fake_quant([0.0, 1.0, -2.0, 8.0], 2, 7)
assert scales == [1/7, 8/7]
assert abs(restored[1] - 1.0) < 1e-12
assert abs(restored[-1] - 8.0) < 1e-12
assert blockwise_symmetric_fake_quant([0.0, 0.0], 2, 7) == ([0.0, 0.0], [1.0])
```
### Q1 参考答案
从命令行参数 `--quantization` 到底层硬件执行 GEMM Kernel,在 vLLM/SGLang 等现代推理引擎中需历经严密的六层系统映射:
1. **CLI 解析与引擎配置层(CLI & EngineConfig Parser)**:命令行解析器捕获 `--quantization fp8`(或读取模型权重目录下的 `quantization_config`),构建全局 `ModelConfig` 与 `EngineConfig`;
2. **注册表匹配与配置实例化层(Quantization Registry & Factory)**:调用 `get_quantization_config(quant_name)`,在静态注册表中根据量化方案名称与 checkpoint 元数据匹配并实例化专用的 `QuantizationConfig` 子类(如 `FP8Config`, `AWQConfig`, `MarlinConfig`);
3. **算子方法注入层(Layer Method Binding & Linear Replacement)**:模型构造期间,`QuantizationConfig.get_quant_method(layer, prefix)` 拦截模型内部的各类线性投影算子(QKV 投影、MLP Gate/Up/Down 等),注入对应的 `QuantizeMethodBase` 算子实现类;
4. **权重声明与分片打包层(Weight Allocation & Parameter Packing)**:调用 `QuantizeMethodBase.create_weights`,在 GPU 显存上声明紧凑打包的低精度整数或浮点张量(如 INT32 容纳 8 个 INT4 权重)以及对应的 Scale 与 Zero-Point 张量;
5. **检查点加载与内存重排层(Weight Loading & Layout Transformation)**:模型加载器将权重写入 GPU,并调用 `process_weights_after_loading`,根据硬件 Tensor Core 的访存特征执行权重交错重排(如 Marlin 的通道交织和局部转置);
6. **运行时前向分发与 Kernel 执行层(Forward Runtime & Kernel Dispatch)**:在每次前向传播的 `apply` 函数中,根据当前的 Batch Size($M$ 维度)、隐层维度($K, N$)以及当前 GPU 的 Compute Capability(如 SM80/SM90),动态选择最优的底核实现(如 Marlin、CUTLASS W8A8 GEMM、FlashInfer FP8 GEMM 或 Triton JIT Kernel)。
### Q2 参考答案
声称“NVFP4 绝对比 INT4 更先进、一定更好”是典型的脱离硬件微架构与负载边界的工程误区:
1. **硬件微架构的原生支持鸿沟(Hardware Capability & ISA Constraint)**:NVFP4 强依赖新一代 GPU(如 NVIDIA Blackwell 架构)原生提供的 FP4 Tensor Core。若在缺乏硬件 FP4 指令集的旧卡(如 Hopper H100 或 Ampere A100)上运行,引擎必须在软件层将 FP4 解包并提升为高精度(Upcasting),不仅无法获得算力加速,反而因为额外的解包开销导致吞吐显著劣于原生 INT4 或 FP16;
2. **W4A4 对比 W4A16 的精度与 Outlier 挑战(Activation Outliers & Precision Risk)**:工业界常用的 INT4 主要是 W4A16(仅权重量化,输入激活保持高精度 FP16/BF16),模型精度通常几乎无损;而 NVFP4 属于 W4A4(权重与激活均压缩至 4-bit)。大语言模型深层网络中普遍存在具有极端数值的通道激活异常值(Outliers),将激活压缩至仅有 16 个离散点位的 FP4,即便有 Micro-scaling 微块缩放保护,在复杂数学推理或长上下文检索中仍存在显著的精度劣化风险;
3. **算子生态成熟度与小 Batch Decode 瓶颈**:INT4 W4A16 拥有经过工业界数年千锤百炼的极致访存优化算子(如 Marlin),在小 Batch 自回归 Decode(极度访存受限)场景下能够将 HBM 带宽打满至 85% 以上。NVFP4 虽然理论计算算力翻倍,但在单并发或小 Batch 场景下受限于两级 Scale 解码访存开销,其实际端到端时延未必优于成熟的 W4A16。
### Q3 参考答案
模型量化后权重显存减半,但系统最大支持的并发请求数(Max Concurrency)仅提升 10%,通常说明系统瓶颈存在严重的非对称性。必须通过精细化显存做账和系统分析来定位根因:
1. **全景显存做账拆解(VRAM Ledger Audit)**:
$$\text{Total VRAM} = \text{Model Weights} + \text{KV Cache Pool} + \text{CUDA Graphs Capture} + \text{Activation Workspace} + \text{Allocator Reserve / Fragmentation}$$
2. **核心嫌疑点逐一排查**:
- **KV Cache 显存未联动压缩**:若请求平均序列较长(如 8K~32K Tokens),KV Cache 的显存消耗量往往数倍于模型权重自身。若 KV Cache 仍维持 FP16 精度,并发提升带来的 KV 显存需求呈陡峭线性增长,权重释放出来的少量空间很快被几个长序列并发吞噬;
- **CUDA Graphs 静态空间硬性挤占**:推理引擎为了消除算子发射开销,通常会为各个 Batch 预捕获 CUDA Graphs。这些图所预留的中间激活缓冲区(Activation Pool)在引擎初始化时就被永久占用(可能高达 10~20 GB),无法转化为 KV Cache 动态池;
- **Runtime 存在解包临时副本或内存泄漏(Shadow Buffers)**:某些低效的量化实现并未在 Kernel 内部流水线反量化,而是由 Python 在前向计算前将 Packed 权重动态解包为 FP16 临时张量,瞬间制造出巨大的显存尖峰;或者在模型加载后未释放 CPU/GPU 上的原始高精度临时张量;
- **显存分配器外部碎片化(Memory Fragmentation)**:PyTorch 底层 CachingAllocator 碎片率过高,导致物理上存在可用显存但无法聚合成连续的虚拟页面。
3. **诊断与定位手段**:在服务运行时导出 `torch.cuda.memory_snapshot()` 观察显存分配树与内存块碎片分布;查询推理引擎 `KVCacheManager` 实际可用的 Free Blocks 数量;在固定 Prompt 长度下递增并发压测,核对显存增长斜率与理论预期的偏差。
## 参考资料
- [vLLM quantization registry](https://github.com/vllm-project/vllm/blob/8e958902eee56ca5158728f1dd5a32246f0246f3/vllm/model_executor/layers/quantization/__init__.py)
- [vLLM quantization base contracts](https://github.com/vllm-project/vllm/blob/8e958902eee56ca5158728f1dd5a32246f0246f3/vllm/model_executor/layers/quantization/base_config.py)
- [SGLang quantization registry](https://github.com/sgl-project/sglang/blob/9deb6952afa483e38f96385a375b96f463da5303/python/sglang/srt/layers/quantization/__init__.py)
- [vLLM quantization documentation](https://docs.vllm.ai/en/stable/features/quantization/)
- [LLM Compressor schemes](https://docs.vllm.ai/projects/llm-compressor/en/latest/guides/compression_schemes/)
- [FP4 promise/performance study (MR-GPTQ)](https://arxiv.org/abs/2509.23202)
源码链接固定到本课审阅 commit;current docs、支持矩阵和默认参数会变化,面试或部署前必须按目标版本重新核对。
:::
::: {.course-pagination}
[**← 上一课**<br>第 5 课:稀疏推理](lesson05.qmd){.pagination-link .pagination-prev}
[**下一课 →**<br>第 7 课:投机采样正确性](lesson07.qmd){.pagination-link .pagination-next}
:::
