flowchart TD
    Init["初始化私有寄存器 acc = 0.0f"] --> LoopK["外层 K 维步进循环 (k0 = 0..K, 步长 T)"]
    LoopK --> LoadTile["全体线程协作: 将全局 A_tile, B_tile 合并加载至片上 As, Bs"]
    LoadTile --> Sync1["第一次 __syncthreads() (写后读 RAW 数据冒险安全屏障)"]
    Sync1 --> Compute["片上计算累加: acc += As[ty][k] * Bs[k][tx] (k 遍历 0..T-1)"]
    Compute --> Sync2["第二次 __syncthreads() (读后写 WAR 覆写保护安全屏障)"]
    Sync2 --> CheckK{"是否遍历完 K 维?"}
    CheckK -->|否| LoopK
    CheckK -->|是| WriteC["边界检查: row < M 且 col < N 则写回 C[row * N + col]"]
第 10 课:共享内存 Tiled GEMM
参考答案版:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
本课目标与完成标准
学完后你应能:实现基础 GEMM K-tile 累加,解释数据复用和两个同步点。
通过必须同时满足:
- 独立补齐本课唯一的代码填空题,并通过给定检查;
- 三个问答题均说明因果链,而不是只报术语;
- 能指出至少一个正确性边界和一个性能取舍;
- 总分不低于 8/10,且没有一票否决级概念错误。
前置关系
- 课程前置:C/C++、线性代数、基本并行编程
- 本课在路线中的作用:Tiled GEMM 让一个 A/B 子块被 block 内多个输出复用,降低每次 FMA 对 global memory 的需求。
核心心智模型
1. 它是什么,解决什么问题
分块矩阵乘法(Tiled GEMM with Shared Memory) 是高性能计算(HPC)与深度学习算子开发中最具里程碑意义的优化技术。它求解通用矩阵乘法:
朴素 GEMM 的“内存墙”灾难(结合图 10-1 与图 10-2 Roofline 模型):
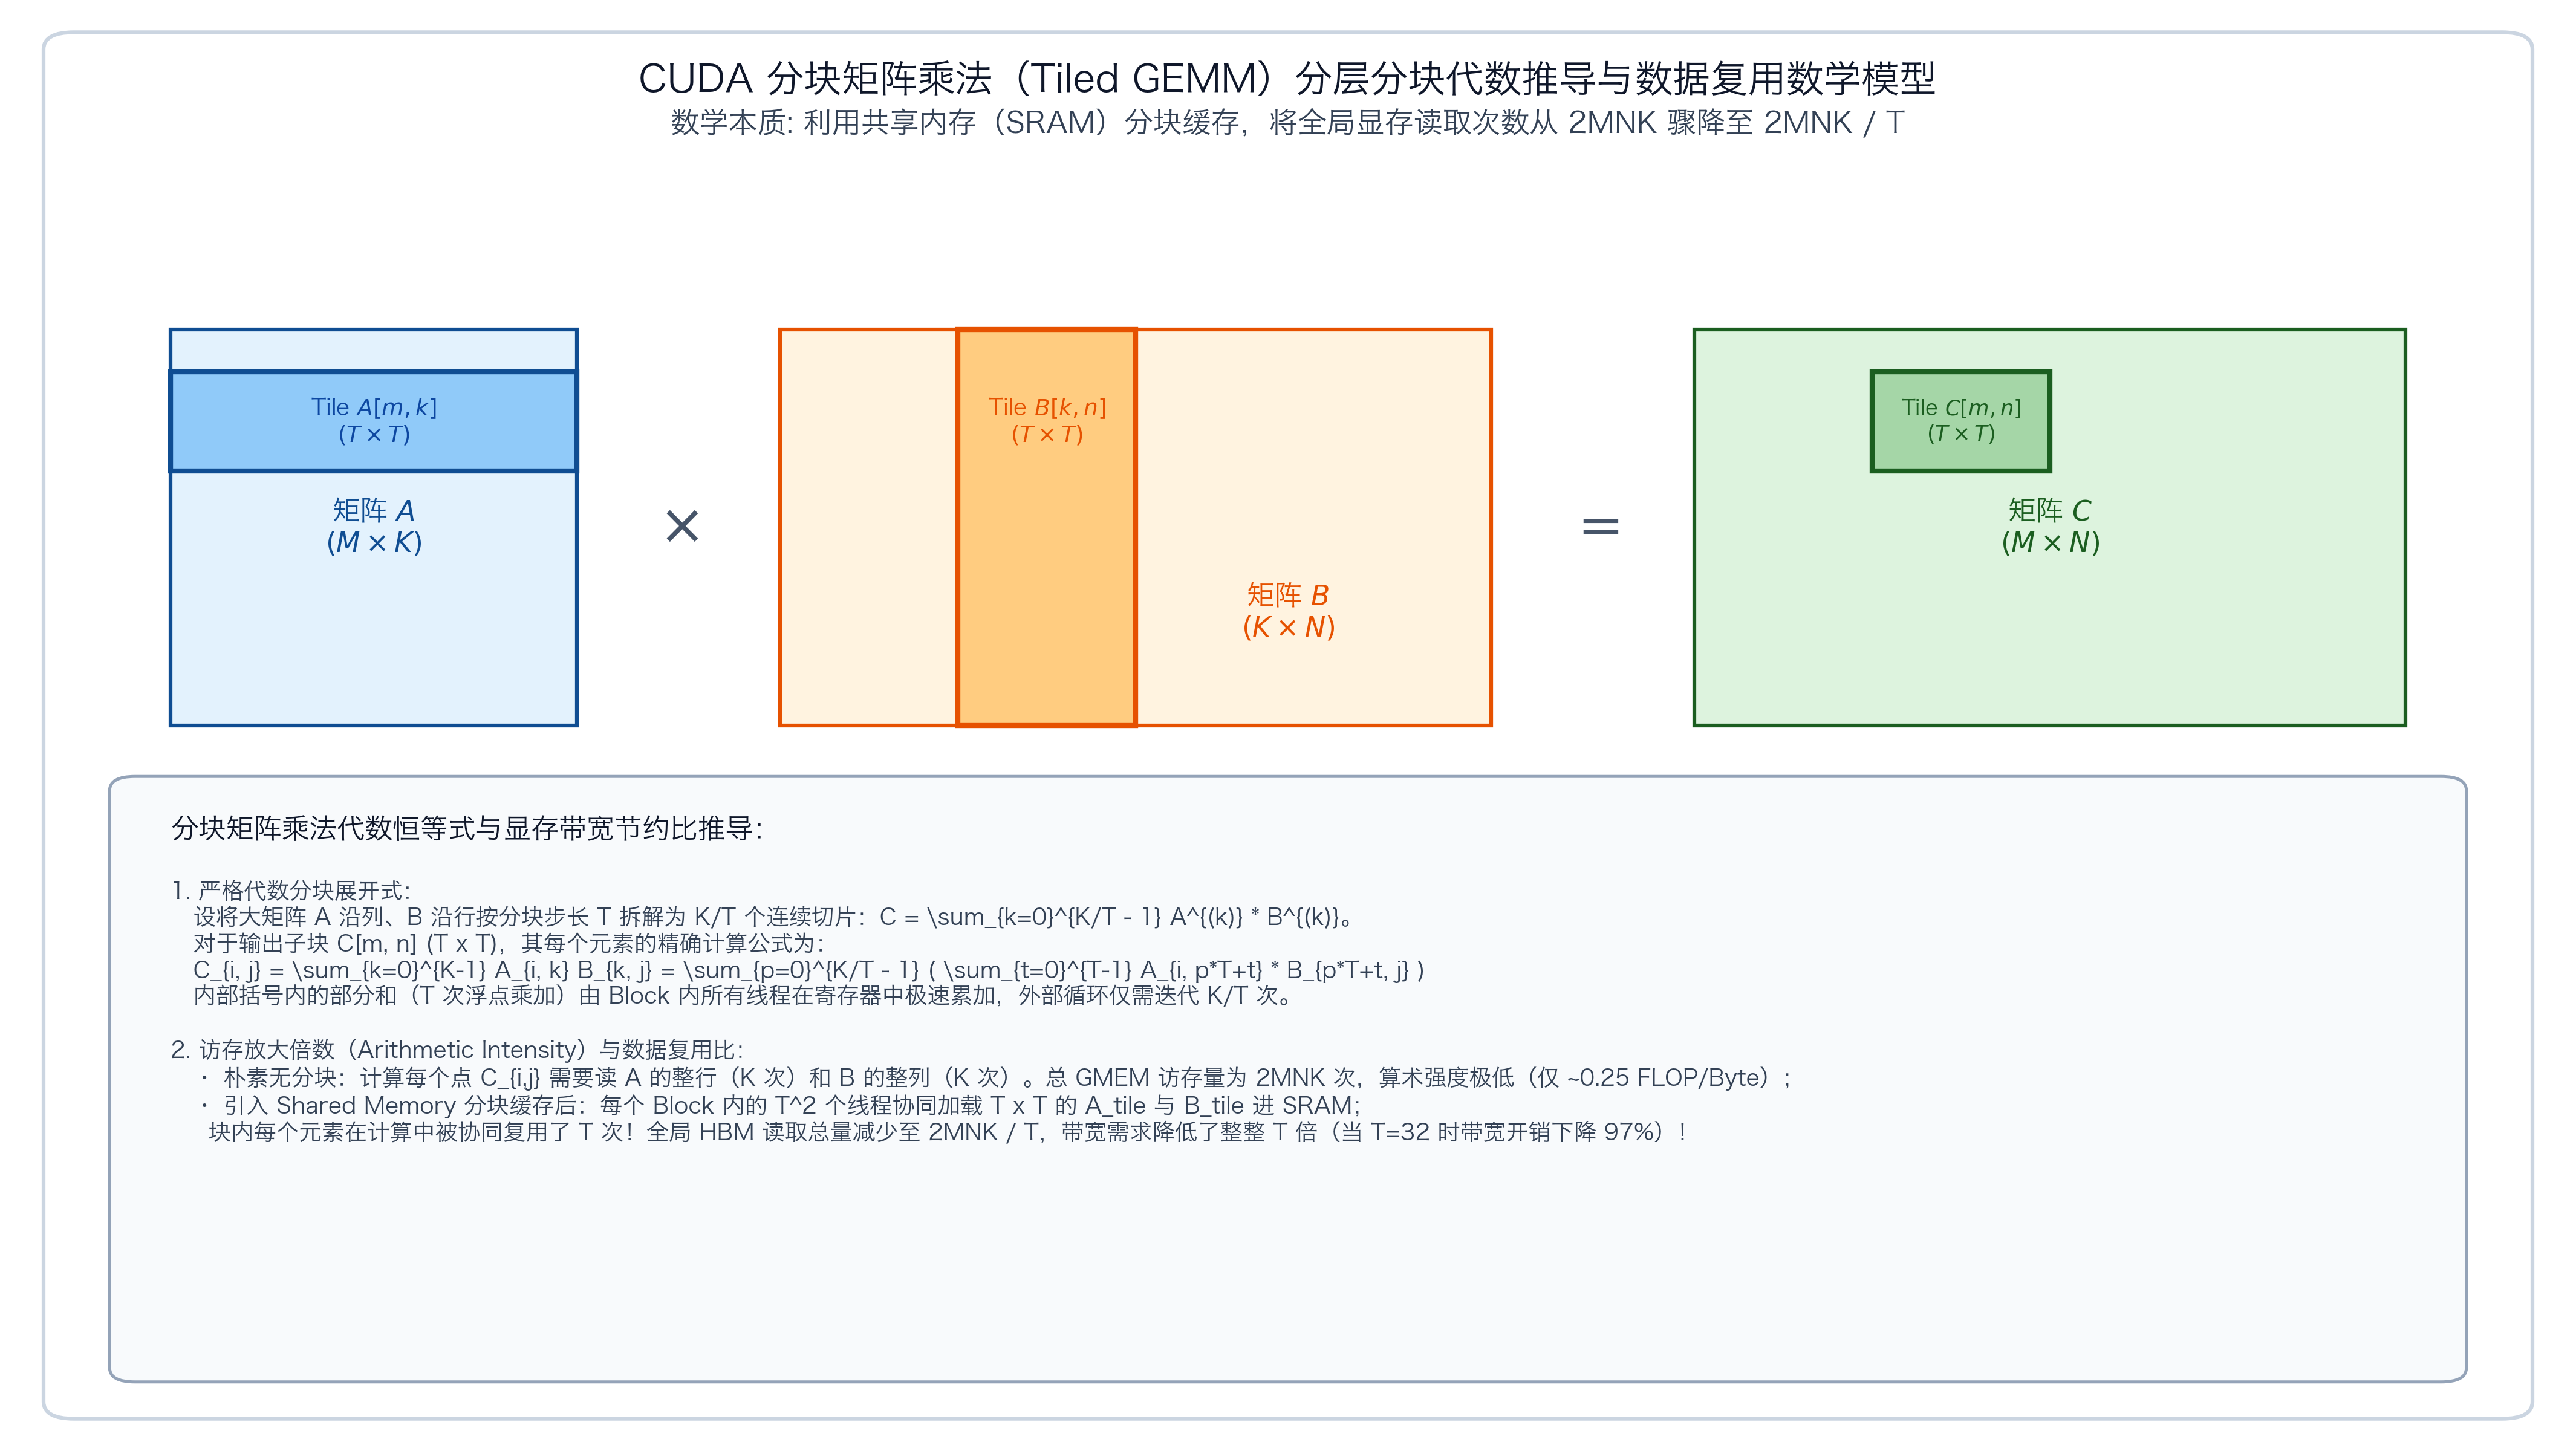
图 10-1:CUDA 分块矩阵乘法(Tiled GEMM)分层分块代数推导与数据复用数学模型
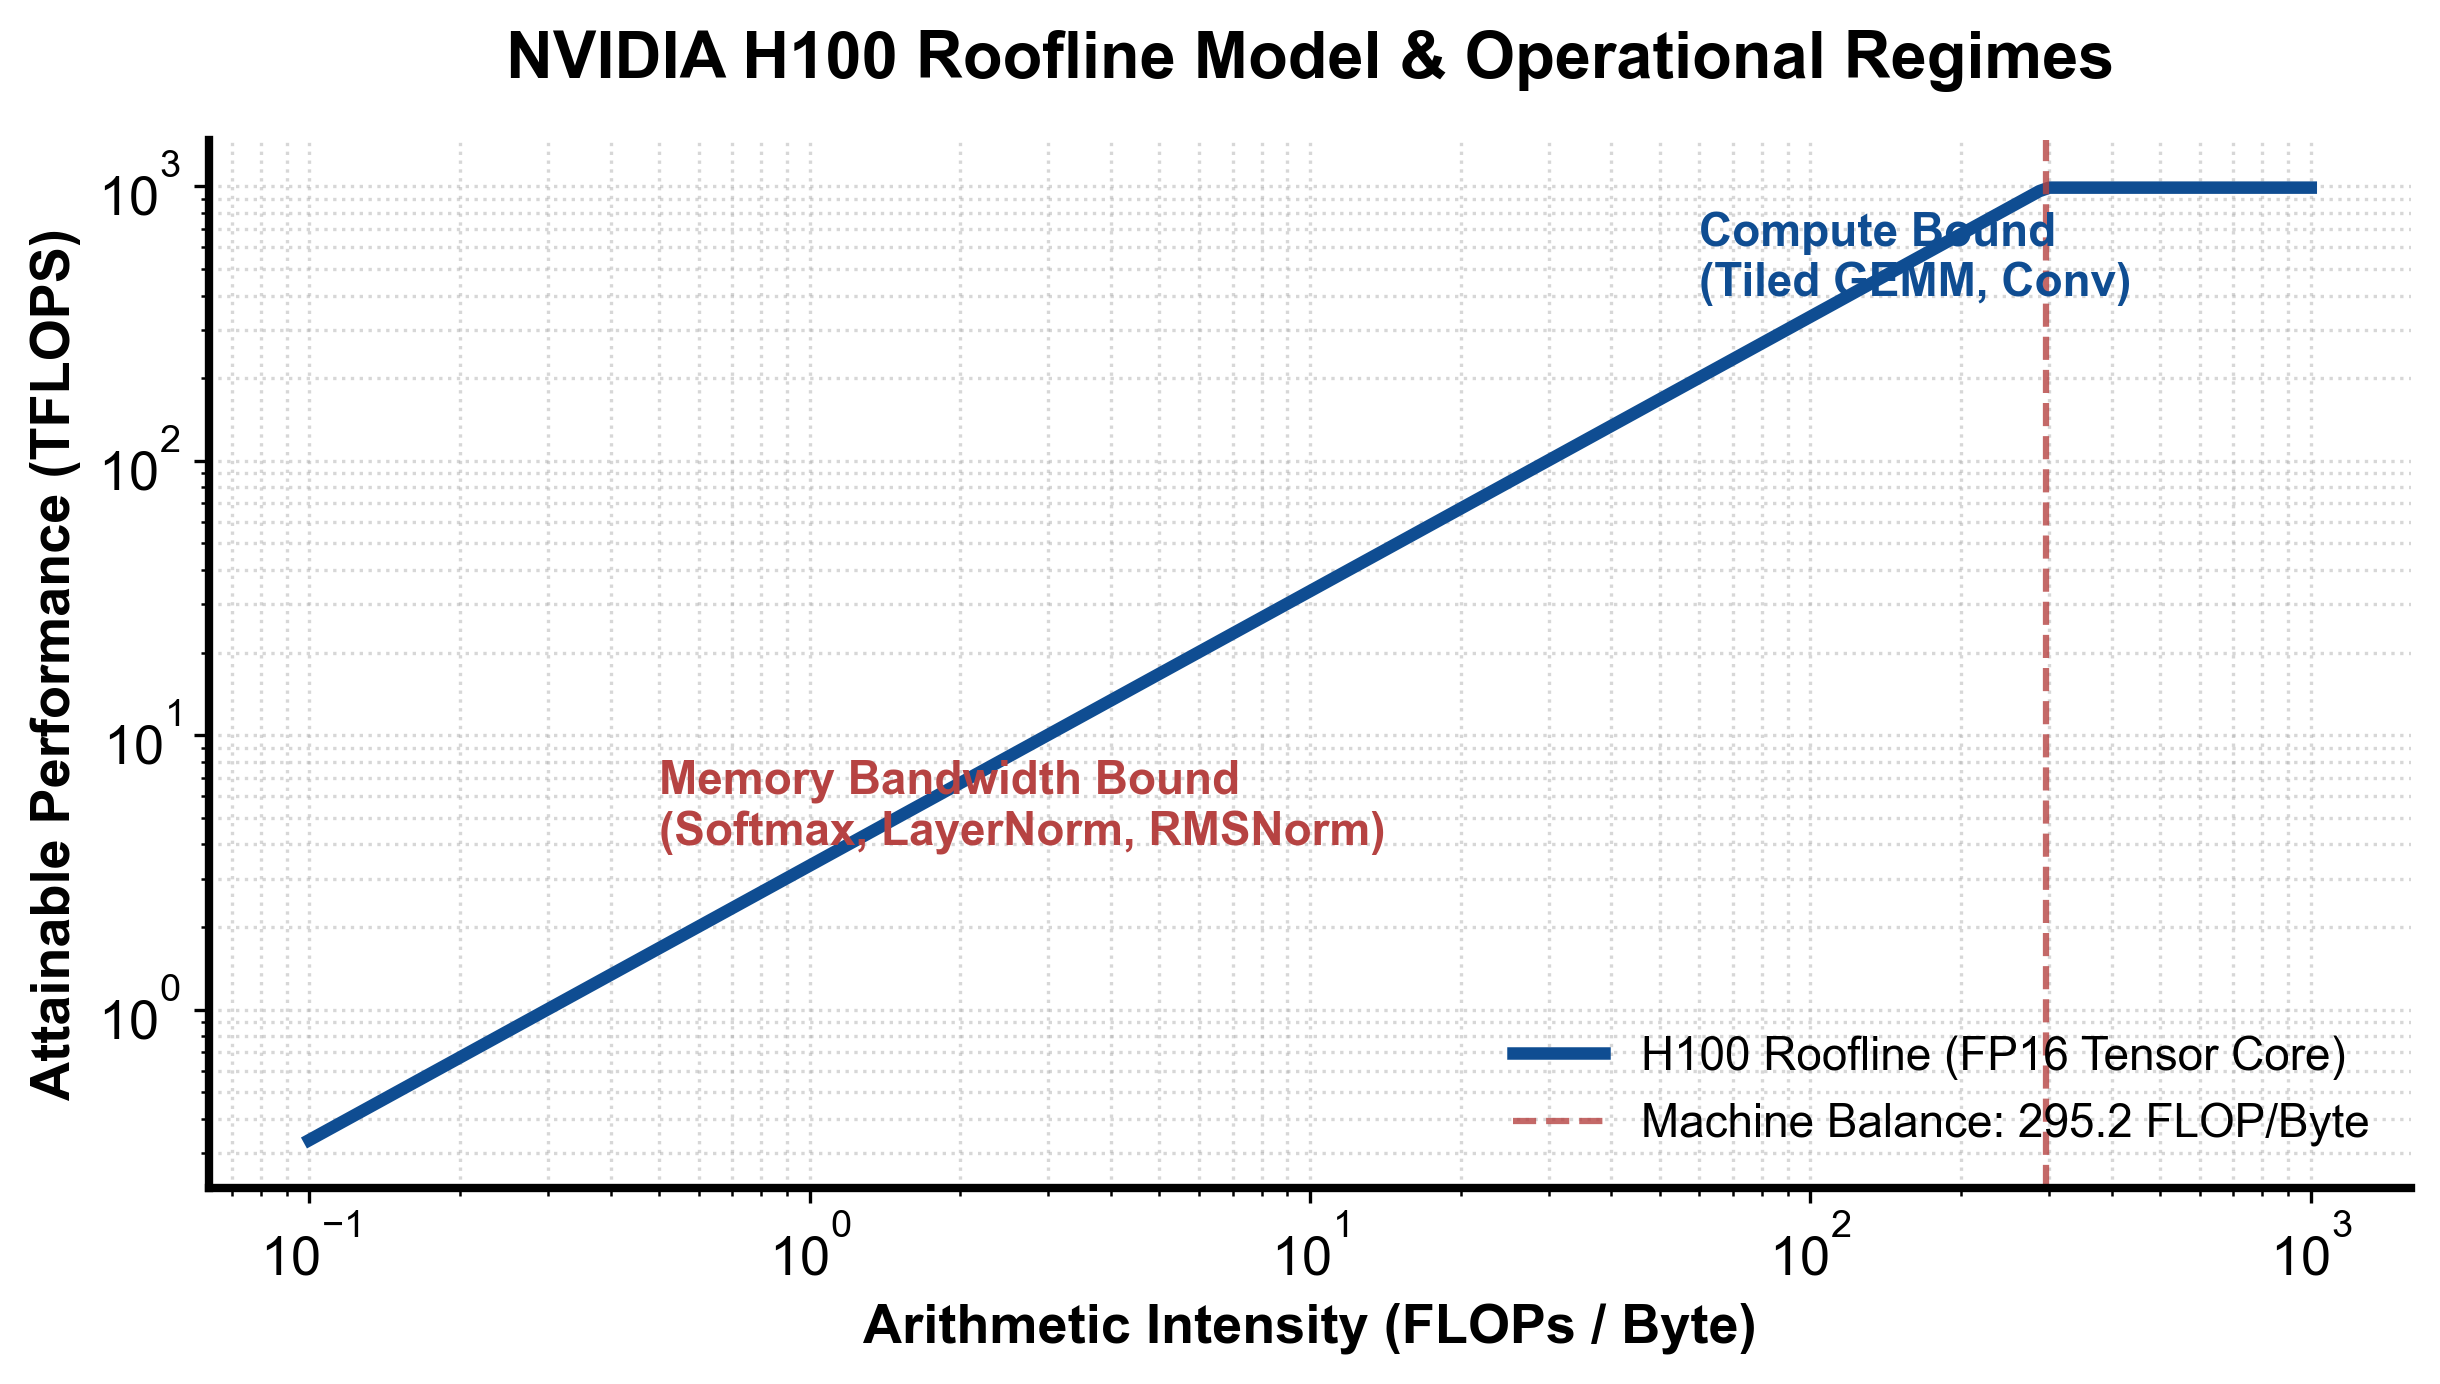
图 10-2:NVIDIA H100 Roofline 性能模型与分块 GEMM 算术强度飞跃曲线
在朴素实现中,每个输出元素 。为了执行 1 次乘加运算(FMA,包含 1 次乘法和 1 次加法,共 2 FLOP),线程必须分别从高延迟的全局显存(Global Memory)加载 1 个 float 的 (4 字节)和 1 个 float 的 (4 字节);
朴素计算的算术强度(Arithmetic Intensity)仅为:
以 NVIDIA H100 为例,其 FP32 向量理论算力约为 67 TFLOPS,而 HBM3 显存带宽仅为 3.35 TB/s。Roofline 模型的硬件算力拐点高达 。朴素 GEMM 深陷严重的“显存带宽受限区(Memory-Bound)”,硬件计算单元利用率甚至不足 2%!
分块复用解法(Tiling):将输入矩阵切分为 的片上瓦片(Tiles),利用极高速的 Shared Memory 暂存数据。瓦片内的数据被 Block 内全体线程重复读取 次,算术强度线性提升至 ,使算子迅速逼近甚至进入 Compute-Bound 饱和区。
2. 它如何工作(结合图 10-1 与图 10-3)
以 为例,一个 ThreadBlock 包含 个线程,负责计算 矩阵中一个 大小的子块:
- 外层分块推进循环(-Loop):
- 沿收缩维度 以步长 步进(
for (int k0 = 0; k0 < K; k0 += TILE)); - 在每轮迭代中,Block 内 256 个线程协同将当前 矩阵的 分块和 矩阵的 分块加载到共享内存
As[16][16]与Bs[16][16]中。
- 沿收缩维度 以步长 步进(
- 第一同步点:写后读保护(Sync 1: RAW Hazard Barrier):
- 调用
__syncthreads()。强制所有线程必须在此等待,直到整个 瓦片的数据全部从全局显存写入共享内存完毕,杜绝过早读取未初始化脏数据。
- 调用
- 片上乘加累加(Compute & Register Accumulation):
- 线程从低延迟的 Shared Memory 中依次读取对应的行与列,在本地私有寄存器
acc中完成当前分块的 次 FMA 累加:
- 线程从低延迟的 Shared Memory 中依次读取对应的行与列,在本地私有寄存器
- 第二同步点:读后写保护(Sync 2: WAR Hazard Barrier):
- 计算完成后,必须执行第二次
__syncthreads()!确保全体线程都已将当前瓦片的数据消费完毕,防止跑得快的线程开启下一轮循环将新的分块数据覆写进As/Bs,覆盖掉跑得慢的线程尚未读取的数据。
- 计算完成后,必须执行第二次
- 边界检查与写回:
- 当 维循环结束,每个线程将各自寄存器中累加出的最终标量
acc合并写回全局显存C[row * N + col]。
- 当 维循环结束,每个线程将各自寄存器中累加出的最终标量
图 10-3:CUDA 分块矩阵乘法(Tiled GEMM)片上分块双重同步屏障流水线架构
3. 正确性条件与常见误区
- 边界线程“中途 Return”导致全 Block 永久死锁:
- 当 或 不是 的整数倍时,边缘 Block 包含越界线程( 或 );
- 一票否决级致命错误:绝不能在 Kernel 开头写
if (row >= M || col >= N) return;!根据 CUDA 规范,__syncthreads()必须由 Block 内的所有物理线程协同调用。若部分线程提前退出,剩余线程将在循环内的栅障处无限等待死锁,最终触发驱动超时挂起; - 正确做法:越界线程必须完整参与全流程与每一次
__syncthreads(),仅在加载显存时填 0(0.0f),并在最终写回 矩阵时通过条件守卫跳过写入。
- 缺漏第二个
__syncthreads()的读后写数据冒险:- 很多初学者误以为每轮循环只需要一次同步。如果没有 Sync 2,不同 Warp 的进度差异会使部分线程过早向
As写入下一个 Tile,摧毁正在执行上一轮计算的线程数据。
- 很多初学者误以为每轮循环只需要一次同步。如果没有 Sync 2,不同 Warp 的进度差异会使部分线程过早向
4. 性能与工程取舍
- 瓦片尺寸 的扩展权衡():
- 数据复用率随 增大而线性增长(复用率由 16 倍翻倍到 32 倍),算术强度提升到 ;
- 但 Block 线程数将从 256 暴增到 1024(达到单 Block 允许的硬件上限),Shared Memory 占用从 2 KB 增加到 8 KB,可能大幅压缩 SM 上的活跃线程块总数(Occupancy),增加尾块浪费。
- 从 Scalar Tile 到 Register Tiling 与 Tensor Core:
- 当前单线程仅计算 1 个输出元素,数据虽然在 Shared Memory 复用了,但在寄存器级别并未复用(每个线程每次都要从 SMEM 读数据);
- 工业级高性能算子(如 cuBLAS、CUTLASS)采用 2D Register Tiling(如每线程计算 个输出),并在现代架构上调用硬件原生的 Tensor Core(如 HMMA、MMA PTX 指令),将算力发挥到极致。
具体演示:数据复用率与访存放大对比演算
考虑矩阵尺寸为 的方阵乘法():
- 全矩阵浮点计算量:(约 2.15 GFLOP);
- 朴素无分块版本(Naive GEMM):
- 计算每一个 元素,线程都必须从 HBM 读取整整一行 (1024 个数)和整整一列 (1024 个数);
- 全局内存总读取次数: 流量;
- 算术强度:。
- 共享内存分块版本( Tiled GEMM):
- 矩阵被划分为 个分块;
- 每个分块在 维推进 64 轮,每轮协同加载 个浮点数;
- 全局内存总读取次数: 流量;
- 总访存量精确减少为朴素版本的 !算术强度跃升为 ,显存总线压力骤降 93.75%。
实践任务:唯一代码填空题
补齐 tile 内乘加。
规则:只能修改 TODO/______ 所在位置;不要删除断言或放宽误差。代码注释说明了每个边界条件。
Code
%%writefile /tmp/10_gemm_tiled.cu
#include <cuda_runtime.h>

namespace {

constexpr int TILE = 16;

// Tiled GEMM: C = A * B
// A: [M, K] row-major
// B: [K, N] row-major
// C: [M, N] row-major
//
// 面试里的重点不是打赢 cuBLAS,而是讲清楚:
// 1. naive GEMM 每个 C 元素都要读一整行 A 和一整列 B。
// 2. shared memory tiling 把 A/B 子块缓存下来,让一个 tile 内多个线程复用。
// 3. 每个 thread 负责一个 C[row, col],在 K 维上分块累加。
//
// 这是精简版:每线程算一个输出元素,TILE=16。
// 更高性能版本会让每线程算多个元素、用寄存器 tile、向量化、cp.async 等。
__global__ void gemm_tiled_kernel(
    const float* __restrict__ A,
    const float* __restrict__ B,
    float* __restrict__ C,
    int M,
    int N,
    int K
) {
    __shared__ float As[TILE][TILE];
    __shared__ float Bs[TILE][TILE];

    int row = blockIdx.y * TILE + threadIdx.y;
    int col = blockIdx.x * TILE + threadIdx.x;

    float acc = 0.0f;

    // 沿 K 维一块一块推进。
    // 每一轮加载 A 的 [row, k_tile:k_tile+TILE)
    // 和 B 的 [k_tile:k_tile+TILE, col] 到 shared memory。
    for (int k0 = 0; k0 < K; k0 += TILE) {
        int a_col = k0 + threadIdx.x;
        int b_row = k0 + threadIdx.y;

        As[threadIdx.y][threadIdx.x] =
            (row < M && a_col < K) ? A[row * K + a_col] : 0.0f;

        Bs[threadIdx.y][threadIdx.x] =
            (b_row < K && col < N) ? B[b_row * N + col] : 0.0f;

        __syncthreads();

        #pragma unroll
        for (int k = 0; k < TILE; ++k) {
            acc += ______;  // TODO: 当前 K 位置的一次 FMA
        }

        // 下一轮会覆盖 As/Bs,所以所有线程必须先算完当前 tile。
        __syncthreads();
    }

    if (row < M && col < N) {
        C[row * N + col] = acc;
    }
}

} // namespace

void launch_gemm_tiled(
    const float* A,
    const float* B,
    float* C,
    int M,
    int N,
    int K,
    cudaStream_t stream
) {
    dim3 block(TILE, TILE);
    dim3 grid((N + TILE - 1) / TILE, (M + TILE - 1) / TILE);
    gemm_tiled_kernel<<<grid, block, 0, stream>>>(A, B, C, M, N, K);
}
检查方法
有 CUDA 环境时执行 nvcc -std=c++17 -c /tmp/10_gemm_tiled.cu -o /tmp/10_gemm_tiled.cu.o;无 CUDA 环境时可运行下方纯 Python/NumPy 仿真单元进行片上分块与边界条件验证。
无 GPU 环境纯 Python/NumPy 仿真验证(即时可运行)
若本地暂无 NVIDIA GPU,可直接运行以下纯 Python 代码,模拟分块瓦片暂存、K-Loop 推进与零填充边界保护:
Code
import numpy as np

def tiled_gemm_numpy_simulate(A, B, tile_size=16):
    """纯 Python 模拟 GPU 共享内存 Tiled GEMM 分块外积累加过程"""
    M, K = A.shape
    K_b, N = B.shape
    assert K == K_b, "矩阵维度不匹配!"

    C = np.zeros((M, N), dtype=np.float32)
    # 模拟 ThreadBlock 2D 网格遍历
    for block_i in range(0, M, tile_size):
        for block_j in range(0, N, tile_size):
            # 局部寄存器累加器瓦片
            acc_tile = np.zeros((tile_size, tile_size), dtype=np.float32)

            # K 维循环推进
            for k0 in range(0, K, tile_size):
                # 模拟全体线程协作从全局内存加载至片上 As, Bs (带边界 0 填充)
                As = np.zeros((tile_size, tile_size), dtype=np.float32)
                Bs = np.zeros((tile_size, tile_size), dtype=np.float32)

                # 填充 As
                sub_a = A[block_i:min(block_i + tile_size, M), k0:min(k0 + tile_size, K)]
                As[:sub_a.shape[0], :sub_a.shape[1]] = sub_a

                # 填充 Bs
                sub_b = B[k0:min(k0 + tile_size, K), block_j:min(block_j + tile_size, N)]
                Bs[:sub_b.shape[0], :sub_b.shape[1]] = sub_b

                # 模拟片上乘加累加 (__syncthreads() 保护后)
                acc_tile += np.dot(As, Bs)

            # 写回输出矩阵 (带边界守卫)
            valid_m = min(tile_size, M - block_i)
            valid_n = min(tile_size, N - block_j)
            C[block_i:block_i + valid_m, block_j:block_j + valid_n] = acc_tile[:valid_m, :valid_n]

    return C

# 单元测试: 使用非 16 整数倍的非对称长方阵验证尾块边界
np.random.seed(42)
mock_A = np.random.randn(35, 45).astype(np.float32)
mock_B = np.random.randn(45, 25).astype(np.float32)

sim_C = tiled_gemm_numpy_simulate(mock_A, mock_B, tile_size=16)
expected_C = np.matmul(mock_A, mock_B)

assert np.allclose(sim_C, expected_C, atol=1e-5), "Tiled GEMM 仿真数值偏离!"
print("Tiled GEMM 跨平台纯 Python 仿真验证 100% 通过!")
提交时请给出:补齐后的代码、实际运行输出(环境不可用时注明“仅静态审查”)以及对失败用例的解释。
Q1
不要背定义:请从输入、状态变化和输出三个阶段解释“共享内存 Tiled GEMM”的工作机制。
你的答案:
Q2
把边界线程直接 return 为什么可能让其余线程死锁?
你的答案:
Q3
从 TILE=16 改 32 时资源与 occupancy 会怎样变化?
你的答案:
评分与通过规则
- 代码 4 分:正常输入 2 分,边界输入 1 分,解释实现 1 分;
- Q1~Q3 各 2 分;
- 一票否决:结果碰巧正确但核心因果链错误、删除边界检查、把未运行结果说成实测。
需要提示时按四级机制请求:概念区域 → 具体方向 → 关键局部 → 完整答案。